Un papel, no una regla
En este artículo
En Claude Code Curious, en Milton Keynes, uno de los organizadores defendió algo con lo que yo acababa de toparme: las skills funcionan mejor escritas como un papel o una metáfora que como instrucciones detalladas. El ejemplo era la documentación. En lugar de enumerar qué debe tener una buena documentación, pedirle al modelo que actúe como un bibliotecario.
La idea es fácil de aceptar y difícil de creer hasta que una regla te falla. Una regla fija qué hacer en cada caso, y un modelo que sigue bien las instrucciones la aplica a todos los casos que encajan, también a los que su autor no tenía en mente. Un papel lleva el propósito que hay detrás de la regla, y el propósito es lo que distingue un caso de otro. Un bibliotecario sabe qué documentos va a venir a buscar alguien.
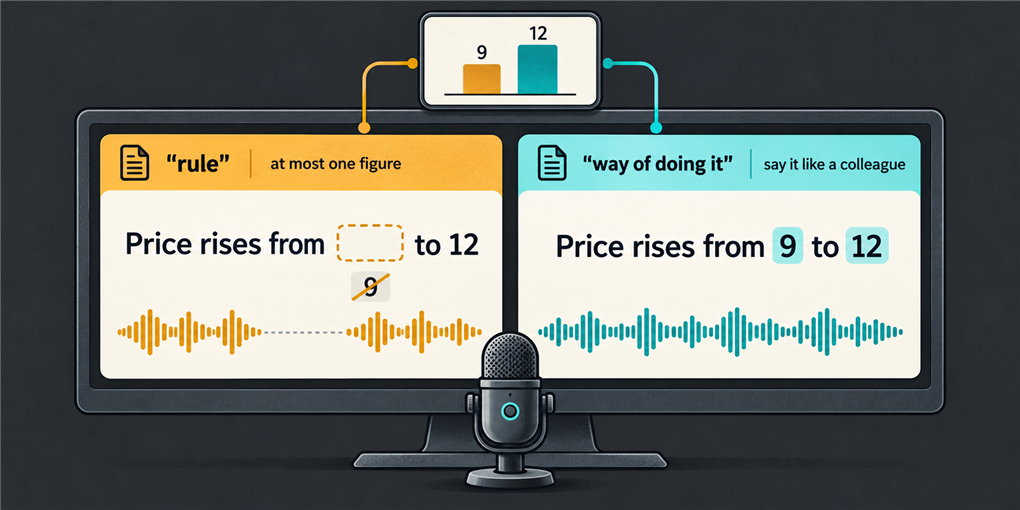
El papel depende de la skill. Bibliotecario para la documentación; en mi caso, un compañero. Así encontré el mío, y esto es lo que pasó cuando lo medí.
La regla que se comió la cifra
Hago vídeos cortos narrados de mis artículos (están en Instagram) con un plugin de Claude Code que escribe el guion: las escenas, lo que dice la voz y lo que sale en pantalla. En algunos, la voz leía ristras de cifras, una detrás de otra, como no habla nadie. Así que añadí una línea a la skill (las skills están en inglés):
Spoken numbers sparingly. Never chain several figures in a row, and avoid repetitive or unround values in the voice: say the one number that carries the point […] and leave the rest on screen or out.
(Números hablados, con moderación. Nunca encadenes varias cifras seguidas, y evita en la voz valores repetitivos o no redondos: di el único número que lleva el mensaje […] y deja el resto en pantalla o fuera.)
Después le pedí a Opus que revisara dos guiones ya escritos con la skill actualizada. Quitó todos los números de la voz:
| antes | después |
|---|---|
| «With the fact in plain sight, Opus adopted the wrong conclusion 4 times in 791.» | «With the fact in plain sight, Opus almost never adopted the wrong conclusion.» |
| «Gemini 3 Flash: 88%, against 3% and 0%.» | «Gemini 3 Flash: almost always, against almost never.» |
La primera línea era el hallazgo de todo el artículo: Opus adoptó la conclusión equivocada 4 veces de 791. Tras la revisión, la voz no decía ni una cifra del estudio.
Así que corregí la corrección, tres veces seguidas. Cada versión de la línea es un commit real:
| versión | qué dice la línea de los números |
|---|---|
| regla | di el único número que lleva el mensaje y deja el resto en pantalla o fuera |
| montones | el problema es el montón, no el número; quédate con la cifra que lleva el mensaje y pasa el resto a pantalla |
| if, a oído | caso por caso: di un número cuando se oiga bien; cuando suene raro, di lo que significa con palabras («almost never») y deja la cifra en pantalla |
| compañero | dilos como se lo explicarías a un compañero: con naturalidad, dentro de la frase; lo único que hay que evitar es leer una tabla en voz alta |
Cada parche era más preciso y ninguno lo arreglaba. El último no es una regla: describe quién habla y a quién. Ese es el que funcionó.
Una historia sobre mis propios vídeos no es una prueba, así que lo medí.
Reproducirlo
Primero, la misma situación: los mismos dos guiones, revisados por Opus con cada una de las cuatro versiones, tres veces cada una.
El titular del primer guion, «4 times in 791», quedó así:
| versión | lo que dice Opus en las tres revisiones |
|---|---|
| regla | «almost never» dos veces, «only 4 times» una (sin el 791) |
| montones | «4 times in 791» las tres veces |
| if, a oído | «almost never» las tres veces |
| compañero | «4 times in 791» las tres veces |
La regla también convirtió «47% with long context» en «more often» las tres veces, que dice menos que la pantalla que tiene detrás. El episodio se reproduce, y el if del parche no es mejor que la regla a la que sustituyó.
Con guiones que no había visto nunca
Esos dos guiones son los que rompieron la skill, y cada versión posterior se escribió pensando en ellos. Así que la prueba de verdad usa material que la skill no había visto: seis artículos míos con resultados experimentales que nunca tuvieron vídeo.
Para cada artículo, Opus escribió un primer guion con la skill tal como estaba antes de cualquier línea sobre números. Esos seis borradores quedan fijos. Después, cuatro modelos revisaron cada borrador con cada una de las cuatro versiones, tres veces: Claude Opus 5.5 y gpt-6-astra (grandes), Claude Haiku 5.5 y gpt-6-luna (pequeños). En total, 288 revisiones.
Dos jueces LLM, Opus y gpt-6.1-sol, leyeron cada revisión sin saber qué versión la había producido. Una revisión pasa si todo hallazgo que el borrador decía con un número se sigue diciendo con un número, o con una fracción exacta como «un cuarto» o «nueve de cada diez». «Casi nunca», «más a menudo» o «mucho más» no cuentan, y pasar el número a pantalla tampoco. Antes de fiarme de los jueces, los comprobé con la reproducción de arriba, donde yo había leído cada línea; coincidieron conmigo. En las 288 coinciden entre ellos en el 92 % de los veredictos.
Así queda en uno de los artículos. El hallazgo del borrador era «iterating solved 86%. Clean restarts: 69%. The button: 91%» (iterar resolvió el 86 %; reiniciar desde cero, el 69 %; el botón, el 91 %). Opus lo revisó así:
- regla: «Clean restarts did clearly worse. The button did slightly better, but not significantly.» (Reiniciar salió claramente peor. El botón algo mejor, pero no de forma significativa.)
- if, a oído: «Clean restarts did worse. The button did slightly better, but not significantly.»
- compañero: «Starting clean every round solved only 69%. The scoped button reached 91%, but its edge over iterating isn’t significant.» (Empezar de cero cada ronda resolvió solo el 69 %. El botón llegó al 91 %, pero su ventaja sobre iterar no es significativa.)
Las dos primeras se leen bien, y ese es el problema. No hay nada falso en ellas; simplemente, el resultado ha desaparecido.
Cuanto más obediente el modelo, peor la regla
La regla pierde la cifra en todos los modelos que de verdad revisan: Opus la conserva en 1 revisión de 18, Astra en 3 y Haiku en 5. El if del parche los separa. Astra y Haiku conservan casi siempre la cifra con él (Astra entre 14 y 18 de 18 según el juez, Haiku 14), y Opus la pierde casi siempre (4 y 0). El modelo que mejor sigue las instrucciones es el que toma «di lo que significa con palabras» y lo aplica a cada número que encuentra.
Eso cuadra con mi episodio, que fue con Opus: cada vía de escape que deja la instrucción, la toma. Y es el argumento general del principio. Cuanto mejor sigue el modelo una regla, más importa que la regla falle en algún caso, y una regla siempre falla en alguno.
Luna es la excepción en el otro sentido. Apenas revisa: devuelve el borrador casi igual, con los números, con cualquier versión. Conservarlos todos no es un mérito, porque Luna ignora la corrección.
Lo que no puedo zanjar con esto es si el compañero devuelve los montones que lo empezaron todo. Los jueces le dieron algo más de cifras leídas de sobra que a la regla, que lo quita todo, pero esa puntuación no la contrasté con mi oído como sí hice con el veredicto principal. En el vídeo que hice con la versión del compañero no oigo ningún montón.
Cuándo basta una regla normal
La misma pregunta con un material más sencillo acota el efecto: un briefing de 40-60 segundos para un podcast interno, solo audio, escrito desde cero en lugar de revisado.
- Una regla con tope, «di como mucho la cifra que lleva el mensaje», también perdió la cifra esencial: Opus la conservó en 6 briefings de 18 y Astra en 4. Cuando la noticia es «de 9 a 12 euros» o «4 de 791», una sola cifra no basta para contarla.
- Una regla sin tope, «no encadenes números no redondos; redondea cuando la fuente lo permita», conservó la cifra esencial en todos los modelos, 17 o 18 de 18. Y limpió el recitado mejor que «como a un compañero».
Así que una regla no falla por ser una regla. El briefing no tenía pantalla adonde mandar los números, y el modelo lo escribía desde cero en lugar de revisar algo que ya los tenía. Mi skill de vídeos tenía las dos cosas: «deja el resto en pantalla» y un guion lleno de números al que aplicarlo. No he aislado cuál de las dos pesa; haría falta la misma skill con y sin pantalla.
Con qué me quedo
Una regla falla cuando le da al modelo otro sitio donde poner las cosas («en pantalla», «con palabras») o un tope («el único número»): un modelo capaz lo usa en todos los casos, incluido el que importaba. Parchearla con condiciones añade más instrucciones que cumplir al pie de la letra. Un papel le da al modelo el propósito, y el propósito sabe qué número es el hallazgo.
Así que antes de escribir la siguiente regla en una skill, me pregunto quién haría bien esta tarea sin que nadie le diera las reglas, y escribo a esa persona. Para la documentación es un bibliotecario; para la narración, alguien que le explica un resultado a un compañero. Donde no había vía de escape ni tope, una regla normal funcionó igual de bien, y a veces mejor.
Los límites: una skill, un tipo de corrección, seis artículos, tres repeticiones por celda, y todo en un solo turno y sin herramientas, cuando mi episodio real ocurrió dentro de una sesión de agente. El patrón se mantiene con dos jueces y en los tres modelos que revisan, y es el mismo con el que me topé a mano. Lo del bibliotecario solo lo conozco por la charla; no lo he medido.
Código, las cuatro versiones de la skill, todos los guiones y los veredictos de los dos jueces con sus razones: skill-framing-experiments. El plugin de vídeos y el resto de mis skills están aquí.