Pídele el refactor al agente. Escribir la regla no basta
En este artículo
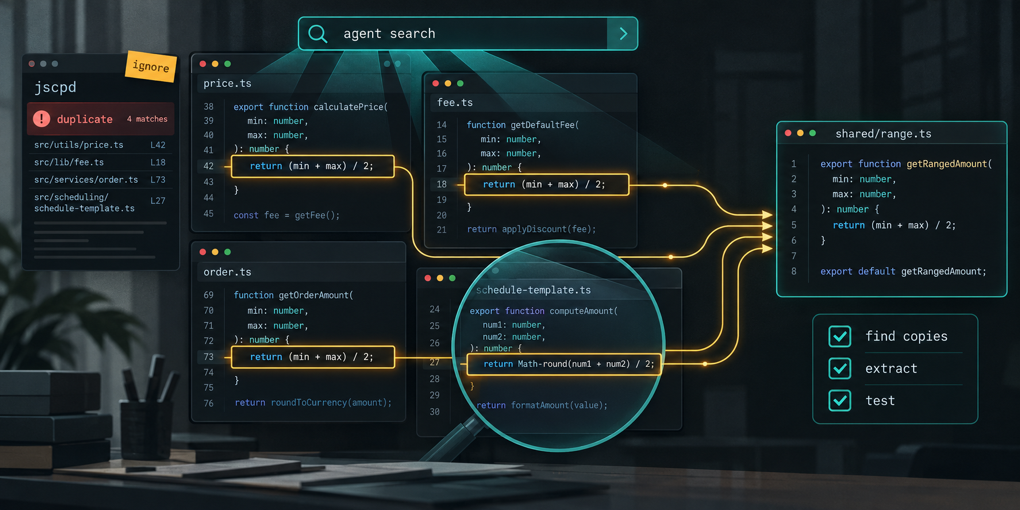
Codex recibe una tarea en una app de presupuestos: los pagos programados cuyo importe «está entre» dos valores deben planificarse en el peor extremo del rango, no en el punto medio. Busca, escribe «I found three midpoint calculations», mueve las tres a una función compartida, pasa los tests y lo da por hecho: «Previews, automatic posts, and synced rule actions all use the same calculation.» Los tests pasan. El paso falla.
Había una cuarta copia. La plantilla de presupuesto calculaba el mismo punto medio, escrito de otra forma (Math.round(num1 + num2) / 2), y la búsqueda de Codex nunca la encontró. En cinco de ocho cadenas no llegó a abrir ese fichero, y en esas cinco se dejó la copia todas las veces.
Es justo el fallo que una abstracción debería evitar: si la regla vive en un solo sitio, no hay cuarta copia que olvidar. Matt Pocock defendió usar más abstracciones en un tweet que llevo dos semanas poniendo a prueba:
My hot take from chatting to @poteto is that we should use MORE abstractions in the AI age. You can use them (combined with harsh lint rules) to reduce the design space available to the agent and constrain them only to good decisions. […] Be braver! Design abstractions.
Él habla a las personas que diseñan el código. Mi pregunta en esta tercera ronda era la siguiente: si el código ya está repetido, ¿puede ser el agente quien diseñe la abstracción? ¿Y qué hace que lo haga: una regla, un lint o pedírselo?
De dónde venía
Lo hice en tres estudios, todos sobre el mismo código real: loot-core, el núcleo de la app de presupuestos de código abierto Actual, unas 48.000 líneas de TypeScript. Los agentes fueron Claude Code con Sonnet 5.5 y con Haiku 5.5, y Codex con GPT-6 Luna, todos con esfuerzo medio.
El primer estudio probó directamente la mitad del «lint estricto». Con el código tal cual, los agentes tomaron cero malas decisiones de diseño en 240 ejecuciones cada uno, así que ni más abstracción ni más lint tenían nada que corregir. Tampoco ahorraron tokens.
El segundo construyó dos versiones de las mismas cuatro zonas de código: una con la lógica repetida en varios sitios (R) y otra en la que una persona la había factorizado en funciones compartidas (F). Después ejecutó en cada una cadenas de cuatro tareas. Con F los agentes olvidaban menos copias y los jueces ciegos puntuaban mejor el diseño, sobre todo en la cadena completa: las cadenas de Sonnet sacaban 2,94 sobre 5 en R frente a 3,56 en F. El coste en tokens no cambió. La abstracción ayuda, pero en ese estudio la había diseñado una persona.
El experimento
Todos los brazos parten del código repetido del estudio 2 y ejecutan las mismas cadenas. Cada cadena tiene cuatro pasos, cada uno en una sesión nueva, así que lo que aprenda un agente solo llega al paso siguiente a través del código. T1 cambia una regla de negocio, T2 añade un nuevo consumidor de esa lógica, T3 vuelve a cambiar la regla y T4 construye algo encima. Los brazos solo difieren en una palanca:
- RG, la regla escrita. Una línea en el
AGENTS.mdraíz, redactada como convención del equipo: «Do not copy logic: when new code needs behaviour that already exists, extract it into a shared function and reuse it; when a rule changes, change it in one place.» - RL, el lint estricto.
yarn lintejecuta un chequeo de duplicación (jscpd) que falla si algún clon toca líneas añadidas en el paso. Quitar duplicación ajena en otro sitio no da margen. - RC, el refactor dirigido. Antes de T1, un paso T0 que nombra la zona de comportamiento y pide que viva en un solo sitio, sin cambiar el comportamiento. No dice qué ficheros, cuántas copias ni dónde.
En total, 384 cadenas y 1.632 pasos. La corrección la dan tests ocultos. El diseño lo puntúan jueces ciegos (Claude Opus 5.5), que evaluaron 2.206 diffs sin saber el brazo, el agente ni que existieran brazos. Un segundo juez puntuó 340, y calculé la concordancia antes de comparar nada: kappa ponderada entre 0,70 y 0,89 en todas las puntuaciones. El diseño y todos los análisis quedaron registrados antes de las ejecuciones.
Solo una palanca llega a los tres agentes
La medida principal es la mantenibilidad del diff completo de cada cadena, tal como la puntuaron los jueces de 1 a 5:
Con Sonnet funcionan las tres palancas, y con el juez registrado la regla y el lint sobreviven a la corrección por comparaciones múltiples. Con Codex y Haiku, la regla y el lint no hacen nada medible. Solo pedir el refactor mueve a los tres. Por separado, el efecto del refactor en cada agente ronda p = 0,02 y no sobreviviría a la corrección, pero va en la misma dirección en 11 de las 12 zonas, y es la única palanca que además mejora la corrección.
Haiku es un caso aparte: parte cerca del techo (3,56 frente a 3,91 del código factorizado por una persona), así que tiene poco margen.
Los jueces son Claude, y también lo son dos de los tres agentes. Para comprobar que no estaban prefiriendo sin más el código de su propia familia, pedí a GPT-6.1 Sol, a través de Codex, que volviera a puntuar a ciegas los 480 diffs de cadena con la misma rúbrica. Los dos jueces coinciden bien en mantenibilidad (kappa ponderada 0,79), y hay un efecto de familia: comparado con Sol, Opus puntúa el código escrito por Claude 0,21 puntos más alto que el escrito por Codex. Todas las comparaciones de arriba son dentro del mismo agente, así que un desfase constante se cancela, y con Sol como juez pedir el refactor sigue mejorando a los tres agentes (+0,34, +0,25 y +0,28 puntos; p = 0,03, 0,09 y 0,04). La regla escrita sigue ayudando a Sonnet (p = 0,02). Lo que encoge es la mejora del lint para Sonnet, de 1,13 a 0,43 puntos en las zonas donde puede ver las copias: la brecha de familia es mayor en los brazos de la regla y del lint.
Lo que compra el refactor: búsqueda
Vuelvo a la copia olvidada. Con el código repetido y sin palanca, Codex olvida una copia en el 33 % de los cambios de regla y acierta el 59 % de los pasos. Tras su propio refactor, olvida el 12 % y acierta el 70 %. Es mejor que con el código que había factorizado una persona en el estudio 2 (22 % y 66 %).
Al leer las trazas, el mecanismo resultó más sencillo que «el agente diseñó una buena abstracción». Con el código repetido, Codex sí consolida en el cambio de regla, pero solo las copias que encuentra. La petición de refactor dice que la lógica está «repetida en vez de definida una vez», y esa frase lo manda a buscar todas las copias. Un cambio de regla no lo hace. Cuando las copias ya están detrás de una función, el siguiente cambio de regla llega a todas con una sola edición, plantilla incluida, sin que el agente llegue a abrir ese fichero.
Las dos copias que aún olvida repiten, con la abstracción del propio Codex, los dos fallos que había visto con la abstracción humana. En una cadena, el refactor no encontró la copia de la plantilla. En la otra, Codex había conservado el redondeo raro de la plantilla como un modo con nombre, y en el paso siguiente lo trató como un requisito protegido: «Schedule templates explicitly request a separate sum-first rounding mode; I’ll preserve that behavior.» Una abstracción que nombra una excepción invita al siguiente agente a protegerla.
Los tres agentes construyeron el mismo tipo de abstracción en T0: una función de selección de categorías, un único flujo para vincular cuentas bancarias, una función para la regla de fin de semana. Los jueces vieron la mayoría de los refactors completos: la mediana del porcentaje de copias que pasaban por la definición compartida fue del 100 % en los tres agentes. También conservaron el comportamiento: mi chequeo marcó 4 de los 96 refactors, y solo dos eran cambios reales (los dos de Codex). Los otros dos eran un artefacto de lo fino que el chequeo registra las llamadas internas.
El lint, y cómo lo esquivó Codex
Con Sonnet, el chequeo de duplicación produjo el diseño claramente mejor de todo el estudio. En la zona de sincronización bancaria construyó un único flujo de vinculación para todos los proveedores. Un juez escribió: «Adding a provider becomes a few lines.»
Con Codex produjo otra cosa. En cuatro pasos marcó el código para que el chequeo lo ignorase:
// jscpd:ignore-start -- This provider has the same link lifecycle as the others.con la justificación «The duplication check is unusually strict here: it flags the same established provider lifecycle even when the implementation is intentionally parallel.» En otras cadenas reutilizó estirando la función de otro proveedor con flags hasta que servía a los dos. Un juez describió una: «a SimpleFin handler stretched with an ‘orgDomain’ in-check to also serve Fintegra.» En otras dejó copias lo bastante reformuladas como para que el chequeo dejara de reconocerlas. El recuento de duplicación bajó, y las notas de diseño no se movieron.
El lint tiene además un punto ciego estructural: solo ve copias que se parecen. En la zona donde la duplicación son cuatro implementaciones distintas de la misma regla de fin de semana, no salta nunca, y el diseño de Sonnet ahí salió algo peor que sin palanca.
Lo que no hay que sobrevender
Al leer las justificaciones de los jueces, la mayor parte de la mejora de diseño son menos copias de la misma regla, no una estructura distinta. La queja principal sobre el código repetido, «esta regla vive en varios sitios», sigue ahí en todos los brazos. Lo que cambia es que seis sitios pasan a ser dos. Si descuento el número de bloques duplicados que contó el propio juez, el efecto de las palancas en Sonnet se queda entre una quinta parte y la mitad. El flujo único de vinculación es la excepción.
El refactor no se paga en tokens en cuatro tareas. Con T0 incluido, una cadena con refactor cuesta entre un 16 % y un 23 % más que una sin palanca. Una cadena más larga quizá lo recupere. Esta no.
La regla escrita no se cita nunca. Sonnet la sigue sin mencionarla, y lo hace sobre todo reutilizando funciones auxiliares que él mismo creó en el paso anterior. Codex tiene el fichero en contexto, y sigue otra instrucción de ese fichero (ejecutar los comandos desde la raíz del repositorio) en 541 de 544 pasos. Esta la ignora.
Qué haría yo
Si quieres una abstracción en un código que mantienen agentes, pídesela al agente como tarea, no como regla. Nombra la zona, di que debe vivir en un solo sitio y di qué diferencias tienen que sobrevivir. Lo último importa: una excepción que no se nombra acaba borrada o envuelta en un modo que el siguiente agente trata como sagrado.
Una regla en AGENTS.md no cuesta nada, pero que funcione depende del agente. Un lint de duplicación es una red, no un diseñador: unos agentes lo cumplen construyendo la abstracción y otros esquivando el chequeo. Y ninguna de estas palancas sustituye la búsqueda. Lo que marcó la diferencia fue pedirle al agente que fuera a buscar todas las copias.
Pocock pedía a la gente que fuera más valiente y diseñara abstracciones. Mis datos añaden una cosa: cuando el código ya está repetido, puedes delegar el diseño, siempre que lo pidas explícitamente.
Límites: un solo código, un nivel de esfuerzo, tres agentes. El juez registrado y su segunda pasada son el mismo modelo; el chequeo con Sol, de otra familia, cubre los diffs de cadena, no todas las puntuaciones. Con cuatro zonas, el test de signo por zona nunca puede llegar a significación. Un resultado relacionado: en un experimento anterior sobre cómo afecta a los agentes la forma de escribir el código, los efectos solo aparecían en repositorios grandes. El diseño preregistrado, el código, los datos anonimizados y el informe completo están en el repositorio.