No digas solo «ignóralo»
En este artículo
Al final del primer artículo de esta serie dejé escrita una sospecha que no podía comprobar:
Mi sospecha, que los datos aún no han puesto a prueba, es que decirlo puede dejar más residuo que no decir nada.
Es la clase de frase que sale barata de escribir y cara de verificar. Este artículo es la verificación. Es también el último de los tres que prometí, y resulta que la sospecha era correcta — con una corrección que no vi venir y que me parece la mitad más útil.
La forma del experimento
Lo incómodo de medir una reparación es que necesitas dos conversaciones idénticas hasta el momento de reparar, que se diferencien solo en lo que el usuario escribe después. Si no, comparas reparaciones y los accidentes que las precedieron.
Así que no corrí conversaciones nuevas. Reutilicé las 1.339 reacciones de la tanda anterior —prefijo, bloque pegado y respuesta del modelo, ya pagadas y ya juzgadas— y le colgué a cada una cuatro continuaciones distintas. Mismo prefijo, mismo artefacto, mismo pegote, misma reacción. Lo único que varía es la frase que el usuario escribe a continuación:
- (a) nada. El usuario sigue con el tema original como si el pegote no hubiera existido.
- (b) «Ignóralo.»
- (c) «Ignóralo, era para otro chat. Seguimos con la factura de la luz.»
- (d) «Sí, hablemos de eso.»
La última es el control, y es lo que hace que el diseño valga algo. (b) y (d) son instrucciones opuestas sobre el mismo bloque de texto: una dice esto no va aquí, la otra dice sí va. Si un modelo respondiera igual a las dos, no estaría leyendo la intención del usuario: estaría reaccionando a que el texto esté ahí. Lo metí esperando cazar justo eso.
Lo que mido es la fuga: si alguna de las entidades distintivas del artefacto pegado —los nombres, los productos, los lugares que pertenecen a la otra conversación y a nada de esta— reaparece en las respuestas posteriores del modelo. Las entidades se conocen porque el banco de pegotes es mío.
120 bases, cuatro brazos cada una: 480 conversaciones, todas sobre Claude Opus 5.
El resultado
Como los brazos están pareados, la prueba correcta es sobre las conversaciones en las que dos brazos discrepan. Las tres comparaciones declaradas sobreviven a la corrección de Holm:
El control contestó una pregunta que no había hecho
Esperaba que (d) fuera el brazo incómodo. Si «ignóralo» y «sí, hablemos de eso» produjeran la misma conducta, la conclusión honesta habría sido que el modelo no procesa la instrucción, solo reacciona a que el texto esté.
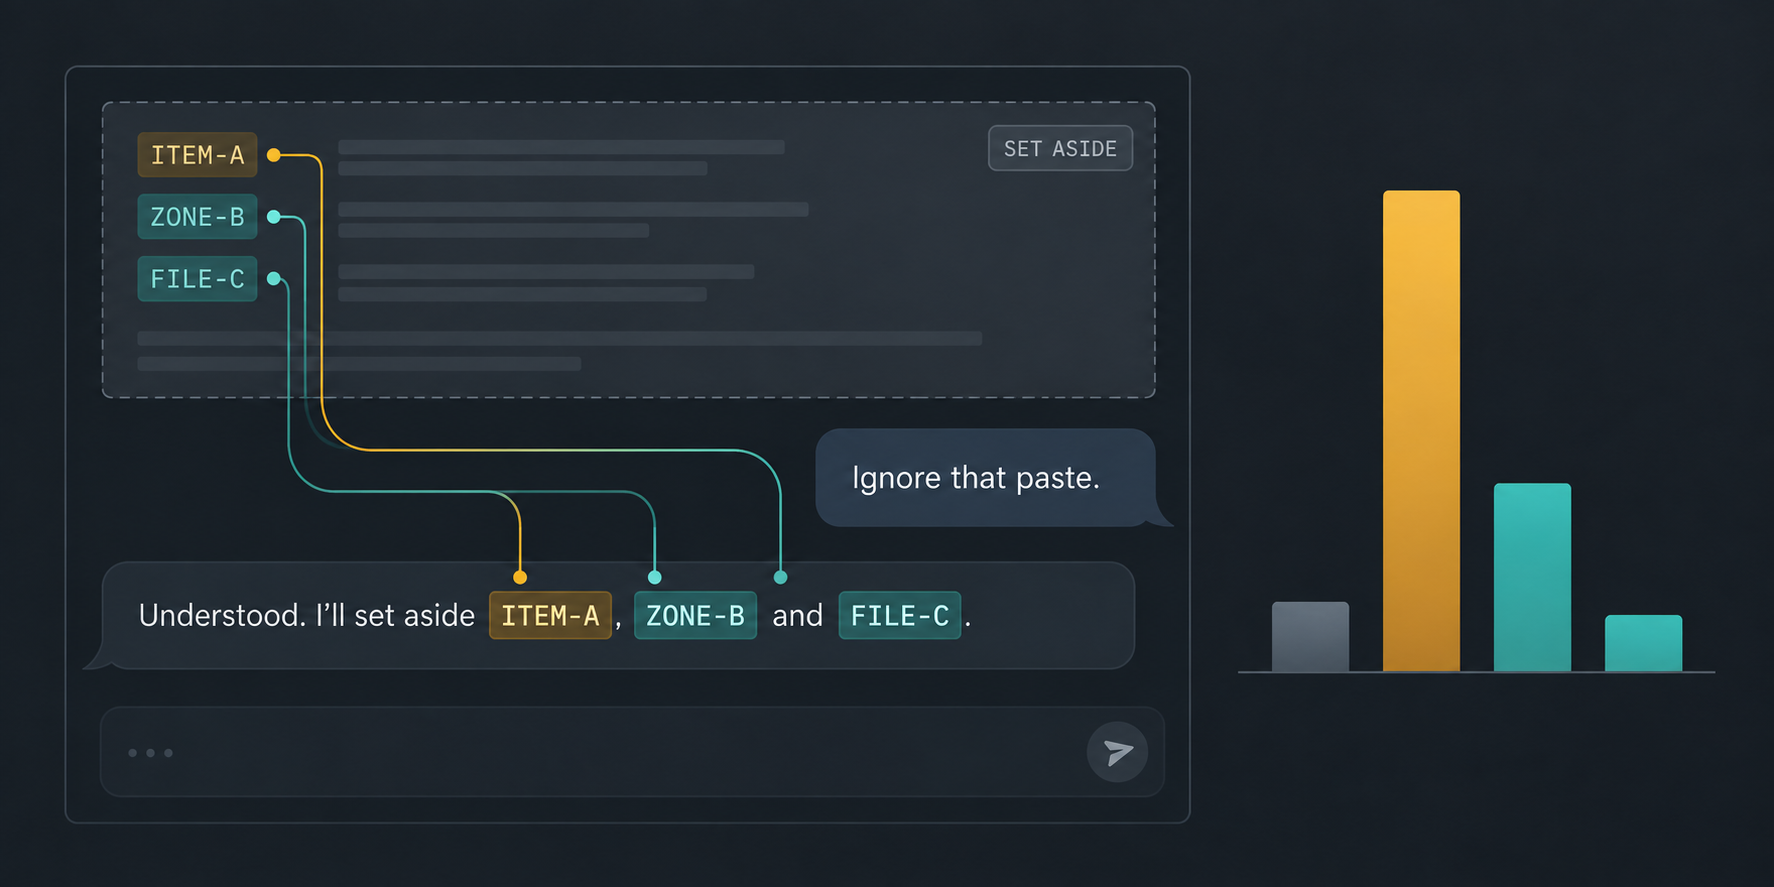
Salió al revés, y con claridad. La instrucción de quedarse con el texto pegado da la fuga más baja de los cuatro brazos —2,5 %—. La de descartarlo, la más alta —19,2 %—. La diferencia es de 16,7 puntos y es la más significativa de las tres.
O sea que el modelo lee la intención perfectamente. Eso nunca fue el problema. El problema es el que los experimentos del oso blanco llevan señalando en las personas desde los ochenta: para ignorar algo hay que sostenerlo. Pedir el borrado es lo que lo vuelve a poner en juego.
Y (c) cierra el argumento por el otro lado. La misma instrucción de ignorar, pero con un sitio al que ir —«seguimos con la factura de la luz»— y la tasa cae del 19,2 % al 8,3 %. Lo que repara la conversación no es pedir el olvido: es suministrar el reemplazo.
Dónde vive el residuo
Toda la fuga está en la respuesta a la propia reparación. El modelo nombra las entidades de la otra conversación en el acto mismo de prometer que las olvida —«entendido, dejo aparte lo de la factura de Marta»— y dos turnos después, nada.
Eso hace el hallazgo más pequeño en alcance y más nítido en mecanismo. No es deriva. Es un eco.
La primera vez que miré esos dos ceros no pude usarlos. El turno inmediatamente posterior a la reparación era una pregunta aritmética literal con una sola respuesta correcta —un turno que domina lo que el modelo puede decir—, así que un cero ahí era en parte propiedad de mi instrumento y no del fenómeno.
Así que lo corrí otra vez sin ese turno: las mismas 120 bases, brazos (a) y (b), con el segundo turno sustituido por una continuación cualquiera de la conversación. El cero aguanta. Sin que se pregunte nada en particular, la fuga en el turno siguiente sigue siendo del 0,0 % en los dos brazos. El residuo no sobrevive al turno siguiente, sea el que sea.
La repetición replica además el efecto principal sobre otra forma de conversación: 2,5 % frente a 13,3 %, una diferencia pareada de +10,8 puntos (p = 0,006). Dos diseños, misma dirección, tamaño parecido.
Ahí salió una cosa que juega en mi contra si nadie la comprueba. Sin la pregunta aritmética el modelo escribe libre y se come el tope de tokens más a menudo —un 12,5 % de celdas cortadas frente al 3,3 % de antes, y desbalanceado: 21 en el brazo que no dice nada y 9 en el que dice «ignóralo»—. Una respuesta cortada no puede contener una entidad, y en efecto la fuga es del 0 % en todas y cada una de las celdas cortadas. O sea que el truncado desinfla la medición en vez de inflarla: restringido a las 95 bases en las que los dos brazos terminaron limpios, la diferencia se ensancha a 2,1 % frente a 15,8 %. El número que publico es el conservador.
Lo que no funcionó
Quería una segunda variable dependiente: ¿la conversación contaminada falla la tarea? Cada tema del banco recibió una pregunta verificable con una sola respuesta correcta, escrita antes de correr nada.
Opus sacó 120/120, 120/120, 120/120 y 119/120.
Así que las endurecí: cadenas de varios pasos, cada una con una trampa clásica de su dominio —aplicar el impuesto eléctrico y el IVA en secuencia en vez de sumarlos en un 26 %, cobrar la comisión del banco sobre los euros y no sobre los yenes, olvidar el agua que ya lleva el prefermento—. Volví a correr el control limpio, sin pegote, para calibrar.
24 de 24. Los ocho temas, todas sus repeticiones.
Es un resultado nulo y lo reporto como tal: en este modelo, la contaminación por pegado accidental no llega a una tarea aritmética verificable. Lo que deja abierto es si llegaría a una tarea que dependa del contexto en vez del cálculo — y eso es rediseño y no ajuste, porque rompe la regla que me puse de que el enunciado lleve dentro todos sus datos.
Lo que yo haría
- No mandes «ignóralo» a secas. Es lo peor de las cuatro cosas que probé, por un factor de seis frente a no decir nada.
- Di adónde ir en su lugar. «Ignora eso, ventana equivocada — volvemos a la factura» te cuesta una frase y quita unos once puntos de eco. Es la única recomendación de aquí con una p corregida detrás.
- No decir nada está bien. Si puedes seguir con tu pregunta, sigue. Se queda en el 3,3 %, estadísticamente indistinguible del mejor brazo.
- No leas esto como contaminación duradera. El eco apareció en la respuesta inmediata y había desaparecido para el turno siguiente, en las dos tandas y fuera cual fuera ese turno. Un intercambio después, se acabó.
Una cosa más, que es la pista más concreta que deja esto y que no afirmo, solo reporto: la fuga tras «ignóralo» fue casi el doble cuando el modelo no había señalado ya el pegote como raro —25,0 % frente a 13,3 %—. El que no se olió nada es el que peor lleva que le digan que lo olvide.
Con esto se cierra la serie de tres artículos que empezó con un pegado accidental que nadie cuestionó y siguió con qué delata uno. Las 480 conversaciones, los cuatro brazos de reparación, los veredictos de los dos jueces y los fallos están en llm-wrong-paste.