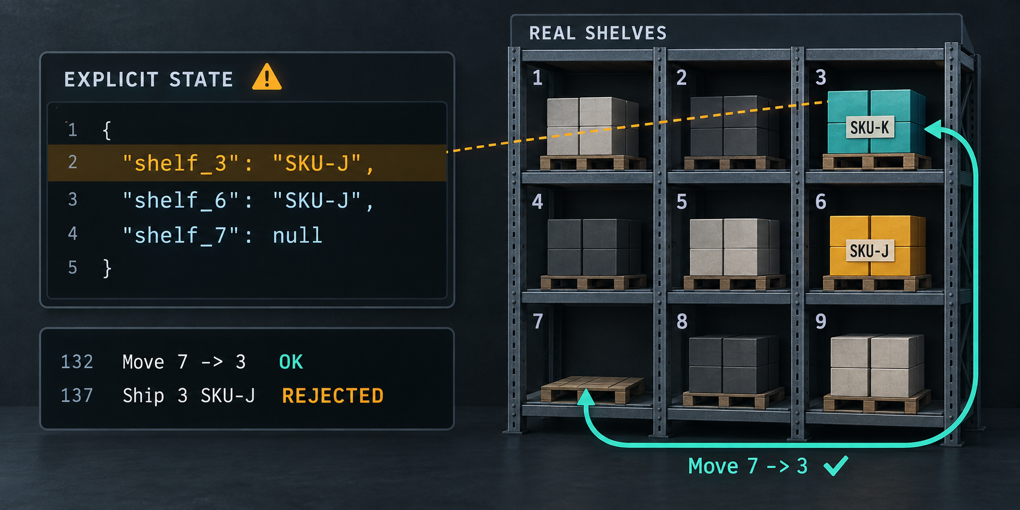
El estado explícito no olvida. Recuerda mal.
En este artículo
En la primera mitad de esta réplica corrí
SKILL.state sobre Claude y la degradación que el paper
pone en titulares no aparecía. La objeción obvia es que el paper usa Gemini-3-Flash, no
Claude. Así que esta mitad corre sobre el suyo —gemini-3-flash-preview por Vertex, en un
entorno reconstruido para ajustarse a su Apéndice B— y además sobre Claude Haiku 4.5 con
el mismo entorno y el mismo tope de salida, con cada celda repetida y cada episodio
guardado como traza paso a paso.
La versión corta: la tesis central del paper se sostiene con su propio modelo, y de forma más limpia de lo que el paper la reporta. Con un segundo modelo no, y lo interesante es cómo falla. El estado explícito no pierde el hilo del procedimiento. Escribe mal el estado, y nada comprueba lo que escribe.
Repetir cada celda, incluso a temperatura cero
El protocolo partía de un supuesto que suena seguro: con decodificación greedy, una seed es
una instancia del entorno y basta con una tirada por celda. No basta. La misma celda,
repetida cinco veces a temperature=0, sacó entre 0,830 y 0,960. La distribución
tiene una cola izquierda larga porque los fallos encadenan: el agente guarda un palé en la
estantería equivocada y cada decisión posterior que toca esa estantería hereda el error.
Tres conclusiones redactadas a partir de tiradas sueltas —un efecto del entorno, una curva de ruido monótona, una estimación del ruido— no sobrevivieron a la repetición. Todas las cifras de abajo son medias sobre 15 a 24 tiradas, con la dispersión calculada sobre las tiradas, no sobre las medias por seed.
Con su modelo, la tesis se sostiene
Su Tabla 1 tiene cuatro runtimes: ReAct (historia completa), Memory (resumen móvil), Stateful (bloque de estado más historia) y SKILL.state (solo bloque de estado). Estos son los dos que cargan con el argumento, los nuestros frente a los suyos:
SKILL.state no falla ni una vez en 75 episodios de hasta 200 pasos, donde el suyo
pierde seis puntos. La dirección de su tesis se reproduce con margen. La magnitud no:
nuestro ReAct pierde 0,080 entre 10 y 200 pasos donde el suyo pierde 0,160, y queda
17 puntos por encima del suyo en T=200. Variar el presupuesto de razonamiento, el tope
de salida y las tres diferencias de entorno que encontré frente a su apéndice no lo mueve.
El nombre del modelo es el suyo, pero gemini-3-flash-preview puede no ser exactamente el
checkpoint que hay detrás de su Gemini-3-Flash, así que no puedo descartar el modelo:
solo decir que no lo cambié.
Memory es el único brazo en el que la comparación es entre dos cosas distintas. El paper no especifica cómo resume su Memory, así que una réplica tiene que elegir una política, y la nuestra guarda un resumen mucho más apretado: en T=200 su prompt medio es la catorceava parte del suyo. Con ese resumen más apretado, Memory es el brazo que más degrada, el último en T=100 y T=200. Cuánto de eso es del resumen como tal y cuánto de lo fuerte que comprime, estas tiradas no lo pueden decir.
Con un segundo modelo, el estado explícito escribe mal el estado
El mismo entorno, el mismo tope de salida, Claude Haiku 4.5 por Microsoft Foundry, 24 tiradas por celda en los dos extremos del horizonte:
| T=200 | ReAct | Stateful | SKILL.state |
|---|---|---|---|
| Gemini-3-Flash | 0,913 | 0,930 | 1,000 |
| Claude Haiku 4.5 | 0,974 | 0,999 | 0,958 |
En Haiku el orden se da la vuelta. El brazo de historia completa está casi plano (−0,005 de T=50 a T=200) y el que cae es SKILL.state. Para saber por qué, reproduje cada episodio contra el entorno real y comparé, paso a paso, el inventario que el modelo cree —el de su objeto de estado— con el que hay de verdad en las estanterías.
Todos los fallos del estado explícito tienen el mismo origen. En los 17 episodios en que la
creencia se apartó de la realidad, el paso que la corrompió fue un Move ejecutado
correctamente con el parche de estado mal escrito. Move es la única transición que
obliga al modelo a copiar el contenido de una estantería en otra clave de su propio estado,
y es en esa copia donde se equivoca.
Es sistemático, no ruido: en 6 de las 8 tiradas de la seed 2 la corrupción ocurre en ese mismo paso, y a partir de ahí el agente encadena unos 25 fallos. No todo parche mal escrito importa —en la seed 0 el modelo copia mal el número de lote, que ninguna decisión posterior lee, y esas tiradas no pierden nada—, pero lo que se escribe nunca se contrasta con lo que hizo la acción. Gemini no cometió este error en 75 episodios; Haiku escribió al menos un parche erróneo en 17 de 24 en T=200.
El paper sí estudia actualizaciones de estado erróneas: sobrescrituras prematuras, errores de esquema y de tipo. Esto es algo más estrecho: un parche válido según el esquema con un valor equivocado dentro, que pasa todas las comprobaciones que hace el runtime.
Conservar la historia lo absorbe
El brazo Stateful es el control que lo hace legible. Mantiene el mismo tipo de bloque de estado y además conserva la historia completa. En Haiku comete el mismo tipo de error de escritura —su creencia se aparta de la realidad en 8 de 15 episodios en T=200, siempre con la acción correcta y el parche mal escrito— y no le cuesta nada: el estado erróneo prescribe otra acción en solo 4 pasos, y en los 4 el modelo hace lo que exige la realidad. Ninguno de sus fallos viene de su estado.
En Gemini el mismo brazo se comporta al revés: su estado se desvía en 11 de 15 episodios, cuando SKILL.state con el mismo modelo no se desvió nunca, y 77 de sus 211 fallos ocurren con el estado correcto delante. Stateful y SKILL.state también difieren en el formato de respuesta, el parser y los reintentos, así que esto describe el efecto de la historia, no lo aísla. Pero la lectura práctica cuesta evitarla: con el modelo que recuerda mal, la copia redundante de la historia es lo que lo recoge.
Donde gana el estado explícito, medido por la decisión
El experimento de recuperación del paper pregunta qué pasa cuando un hecho que le dijeron al agente deja de ser cierto. Lo mido por episodio: en una trayectoria correcta, la corrección decide exactamente un paso en cada uno de los tres escenarios usados, así que la pregunta es si el agente acierta ese paso. Ahora con tres modelos y el mismo diseño en cada uno:
El estado explícito aplica la corrección en 70 de 72 episodios (intervalo de Wilson al 95 %, 90–99 %); la historia completa, en 10 de 72 (8–24 %). Es la tesis del propio paper y se reproduce limpia. También es menos que el «93 de 93» que di en la primera mitad: aquel recuento leía los pasos dependientes de una trayectoria simulada en lugar de la trayectoria real del agente, y no podía registrar un fallo que viniera de que el agente no hiciera nada. Medido sobre la trayectoria real, la dirección se sostiene y la perfección no.
La otra sonda pone a prueba la limitación que el paper declara: el estado explícito solo
protege lo que su esquema previó. Un hecho anunciado en el paso t se vuelve relevante por
primera vez en el paso t+40, y el agente lo guardó en algún sitio o no.
| SKILL.state, el hecho hace falta 40 pasos después | Haiku 4.5 | Gemini-3-Flash |
|---|---|---|
| Sin campo dedicado | 0/24 | 0/24 |
Campo libre notes | 10/24 | 1/24 |
| Campo del esquema que nombra el hecho | 24/24 | 16/24 |
Sonnet 5 no está en esta tabla porque una cuarta parte de sus episodios nunca llega a la
prueba —su trayectoria ya ha divergido en el paso t+40— y sus celdas necesitan dos tasas
para leerse con honestidad; están en el paper.
Tener un sitio donde ponerlo no basta: el sitio tiene que decir qué va ahí. «Sin campo dedicado» no significa sin dónde guardarlo —los pocos aciertos de Sonnet en ese brazo escribieron la cuarentena directamente dentro del objeto de inventario—, pero el campo con nombre es lo que funciona de forma fiable, y estos experimentos no separan el hueco extra de la pista que da su nombre. Para el runtime sin esquema alguno, un recordatorio pegado a la observación hace el trabajo: ReAct pasa del 0–34 % al 71–96 % en los tres modelos.
La factura
La mitad de costes del primer artículo se mantiene. Con un procedimiento corto, la caché reduce la ventaja de SKILL.state sobre la historia en coste de entrada de 7,5x a 1,4x en Anthropic, porque una historia que solo crece es el prefijo cacheable ideal y un bloque de estado que muta no lo es. En Vertex la misma cuenta apenas mueve la proporción —7,5x en tokens son 7,2x en entrada efectiva— porque allí la caché implícita le ahorró a ReAct un 6,8 % de su entrada, frente al 82 % en Anthropic.
Y el orden del prompt, aislado esta vez, es una variable de coste de primer orden. El mismo runtime Stateful, mandando el mismo contenido y con la historia marcada como prefijo cacheable en los dos brazos, cuesta 5,2x más cuando su bloque de estado va delante de la historia que cuando va detrás —869k frente a 168k tokens de entrada efectiva por episodio de 50 pasos— con el mismo score. La plantilla de prompt del propio paper pone el bloque de estado delante.
Lo que me llevo
- El estado explícito hace lo que el paper dice con el modelo del paper. En Gemini no pierde un paso, y aplica las retiradas casi siempre en los tres modelos.
- Su modo de fallo es escribir, no recordar. Un esquema puede validar la forma de un parche; nada en el runtime comprueba que el valor coincida con lo que hizo la acción. Si construyes sobre estado explícito, esa comprobación es lo que hay que añadir.
- Conservar la historia junto al estado es un seguro barato con algunos modelos. A Stateful no le costó nada en Haiku y recogió todas las escrituras erróneas que habrían importado.
- Pon lo que muta al final. Es un cambio de una línea y, medido aislado, una diferencia de 5,2x en la factura.
- Repite la celda. La temperatura cero no garantiza reproducibilidad, y una tirada suelta esconde justo la cola donde viven los fallos.
Cada número de aquí lo recalculó a partir de las trazas paso a paso un revisor adversarial independiente —nueve rondas, con acceso a los datos crudos y a nada de la prosa—, y el paper, las trazas y el código son públicos.
Código, trazas paso a paso y el borrador completo del paper: JaviMaligno/delayed-relevance. El paper original: SKILL.state (arXiv 2608.26263). La primera mitad de la réplica: Cuando el dato deja de ser cierto.