La hipótesis del tiempo exponencial ha caído dos veces. El camino era un signo menos
En este artículo
- El problema: una cena con condiciones
- Qué decía la hipótesis
- El muro
- Contar, no decidir
- La ruta de Claude: una identidad de 1818
- La ruta de OpenAI: deformar el problema y volver interpolando
- El mismo muro, el mismo signo menos
- Qué cambia y qué no
- Qué comprueba Lean y qué no
- La demostración que cabe en un prompt
- Qué me llevo
El 26 de octubre aparecieron dos papers con pocas horas de diferencia. Uno, de OpenAI, se titula The Exponential Time Hypothesis is False. El otro, de Anthropic, firmado por “Claude”, se titula A 2^o(n) Time Algorithm for 3-SAT. Los dos dicen lo mismo: el problema difícil de referencia de la informática, que explico más abajo con una cena, se puede resolver más rápido de lo que nadie creía posible, y una conjetura sobre la que se habían construido cientos de resultados es falsa. Los dos vienen con una demostración comprobada línea a línea por Lean, un programa que verifica matemáticas de forma mecánica. A los dos los encontró un modelo de IA que los laboratorios no han lanzado. El paper de Anthropic fecha el hallazgo el 16 de octubre, “con 14M de tokens de salida y sin intervención humana”; el manuscrito de OpenAI está fechado el 17 de octubre.
Los titulares se quedaron en lo de “la IA resuelve un enigma de hace décadas”. Eso deja fuera lo que a mí me parece más interesante, que es el cómo. He leído los dos papers, y la respuesta no son dos trucos sin relación. Los dos algoritmos chocan con el mismo muro con el que ha chocado todo algoritmo de SAT desde los años ochenta, y los dos lo atraviesan de la misma manera: resolviendo un problema más difícil que el que se pedía y dejando que los números negativos se cancelen. Uno de ellos lo hace con una identidad que un matemático danés escribió en 1818.
Nada de esto hace más rápido ningún software real, y nada de esto resuelve P vs NP, la famosa pregunta del millón de dólares. Llegaré a por qué. Primero, el problema en palabras sencillas, porque sin él nada de esta historia tiene sentido.
El problema: una cena con condiciones
Imagina que organizas una cena y tus amigos te han mandado condiciones. “Voy si viene Ana o si no viene Bea.” “Al menos uno de Carlos y Diego.” “Ana, Bea y Carlos juntos no, por favor.” Cada amigo es una decisión de sí o no, y cada condición menciona como mucho a tres amigos. La pregunta: ¿existe alguna lista de invitados que cumpla todas las condiciones a la vez?
Eso es 3-SAT. “SAT” viene de satisfacibilidad: ¿se pueden satisfacer todas las condiciones juntas? El “3” es porque cada condición, que se llama cláusula, implica como mucho tres variables de sí o no. Escrita como la escriben los informáticos, una cláusula tiene esta pinta: , “viene el amigo 1, o no viene el 2, o viene el 5”.
Parece un pasatiempo, y es el pasatiempo. En 1971 Stephen Cook demostró que una familia enorme de problemas (horarios, rutas de reparto, comprobar que un chip no tiene fallos, sudokus y miles más) se puede traducir a él. Resuelve 3-SAT deprisa y los resuelves todos deprisa. Por eso es el problema difícil de referencia de la informática.
Lo que lo hace difícil es una asimetría. Si alguien te da una lista de invitados, comprobarla es trivial: repasas las condiciones una a una. Encontrar una es otra historia. Con amigos hay listas posibles: con 30 amigos, unos mil millones; con 100, tantas que un millón de ordenadores comprobando cada uno mil millones de listas por segundo tardarían unos 40 millones de años en recorrerlas. La pregunta desde los años setenta es cuánto mejor que “probarlas todas” se puede hacer.
Qué decía la hipótesis
Los mejores algoritmos no lo prueban todo: podan, adivinan con astucia y dan marcha atrás. Pero su tiempo sigue creciendo de forma exponencial: cada variable de más multiplica el trabajo por un factor fijo, la base. Para probarlo todo la base es 2 (un amigo más, el doble de listas). El paseo aleatorio de Schöning la bajó a en 1999, PPSZ con el análisis de Hertli a , el algoritmo determinista de Liu a . Parece poca ganancia y es enorme: es un número de 31 cifras, uno de 12. Pero cuarenta años de trabajo muy ingenioso nunca acercaron la base a 1.
En 1999 Russell Impagliazzo y Ramamohan Paturi convirtieron esa experiencia en una conjetura, la hipótesis del tiempo exponencial (ETH, por sus siglas en inglés): la base se puede bajar, pero nunca hasta 1. Dicho con precisión: existe algún número mayor que 1 tal que ningún algoritmo resuelve todas las instancias de 3-SAT más deprisa que . Por listo que sea el algoritmo, cada variable de más costará siempre al menos ese multiplicador fijo. Su hermana más fuerte, SETH, dice que cuando las condiciones pueden mencionar muchas variables, ni siquiera se puede bajar mucho la base.
Los papers suelen escribir lo mismo con la base fija en 2 y el cambio pasado al exponente. Cualquier base es una potencia de 2, , así que : probarlo todo es , y es más o menos . Bajar la base hacia 1 y bajar hacia 0 son la misma cosa. En ese lenguaje, ETH dice que nunca puede bajar de cierto número positivo fijo.
A un algoritmo que rompe esto se le llama subexponencial, y se escribe : su exponente crece más despacio que para todo . En el lenguaje de las bases, el multiplicador que pagas por cada variable de más va encogiendo hacia 1 a medida que el problema crece. Sigue sin ser rápido en ningún sentido cotidiano, pero es otro tipo de crecimiento, y ETH decía que era imposible.
No era una apuesta cualquiera. El paper de Anthropic cuenta una búsqueda bibliográfica, hecha por Claude, que encontró más de 800 artículos que demuestran al menos un resultado propio solo bajo ETH o bajo algo que la implica. ETH es la razón por la que “sabemos” que k-Clique no tiene un algoritmo , que muchos algoritmos parametrizados son óptimos, que la programación dinámica sobre descomposiciones en árbol no se puede mejorar. En 2019 Ryan Williams dio dos estimaciones por separado: un 70% de probabilidad de que ETH fuera cierta y un 25% de que lo fuera SETH. No son dos trozos del mismo pastel ni tienen que sumar 100%: SETH es la afirmación más fuerte (si se cumple, ETH también), así que solo puede ser la menos probable de las dos. La mayor parte del campo habría dado cifras más altas a las dos.
Los dos papers dan ahora un algoritmo determinista que corre en : para todo acaba siendo más rápido que , es decir, acaba ganando a cualquier base mayor que 1. Eso refuta de una vez ETH, SETH, Gap-ETH y la versión de conteo, #ETH.
El muro
Esta es la intuición de por qué la base nunca llegó a 1, y es el mismo dibujo en los dos papers.
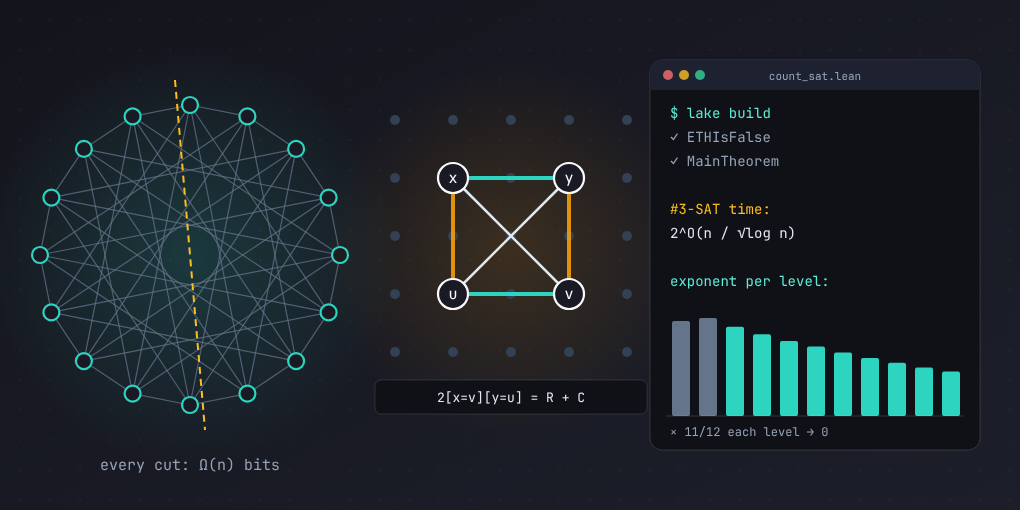
Vuelve a la cena. Dibuja cada condición como un punto, y une dos puntos con una línea cuando mencionan al mismo amigo. El paper de Anthropic dice que cada línea “lleva bits”, uno por decisión de sí o no compartida. El atajo natural es divide y vencerás: parte el dibujo en dos mitades, prueba todas las respuestas posibles solo para los amigos cuyas líneas cruzan el corte y, para cada una, resuelve cada mitad por su cuenta. Si tus amigos forman dos grupos que apenas se conocen, cruzan el corte pocas decisiones, y esto es muchísimo más rápido que probar todas las listas.
El problema es que a los amigos no los eliges tú. Los conjuntos de condiciones aleatorios, y en general las instancias difíciles, parecen grafos expansores, en los que cualquier forma de partir los nodos en dos mitades de tamaño comparable la cruza una fracción constante de todas las aristas. En palabras del paper, “cualquier algoritmo que fije de antemano un árbol de cortes y enumere los bits que cruzan cada corte tarda . Por eso las ideas anteriores de divide y vencerás solo mejoraban la constante del exponente.”
Para atravesar el muro hay que dejar de pagar por cada bit que cruza. Y no hay manera de hacerlo si cada cantidad que manejas significa “número de soluciones de algo”, porque los recuentos de soluciones no son negativos y no se pueden cancelar.
Contar, no decidir
Así que los dos papers hacen algo que suena al revés. No preguntan “¿hay alguna lista de invitados válida?”. Preguntan “¿cuántas listas válidas hay?” y calculan el número exacto, que es el problema #3-SAT y en principio es mucho más difícil (lo mejor que había para contar rondaba , peor que para decidir). Comprobar si la cuenta es cero decide la satisfacibilidad gratis.
¿Por qué complicarse la vida? Porque una cuenta es una suma, y una suma es álgebra. El número de asignaciones que satisfacen la fórmula es
donde cada vale 1 si la cláusula se cumple y 0 si no. Una suma de productos se puede reordenar, reescribir, expandir y reagrupar, y nada obliga a que los términos intermedios valgan 0 o 1, ni siquiera a que sean positivos. En cuanto se admiten números negativos a mitad del cálculo, dos piezas caras pueden cancelarse en una barata. Los algoritmos de ramificación, que preguntan “¿y si es verdadera?”, no pueden hacer esto: cada rama es una subpregunta real con una respuesta real no negativa.
¿De dónde salen los números negativos, si cada lista o funciona o no funciona? De restar, como en el colegio. Toma la condición “viene Ana, o no viene Bea”. Contar directamente las listas que la cumplen es incómodo, porque un o ata a los dos amigos. Cuenta en cambio todas las listas, menos las que la incumplen. Una lista la incumple solo si Ana se queda en casa y Bea viene, y un y se separa limpiamente, amigo por amigo. Con solo Ana y Bea hay 4 listas, exactamente una incumple la condición, así que la cuenta es 4 − 1 = 3. En la fórmula de arriba eso es .
Haz eso con cada condición, multiplica, y la cuenta se convierte en una suma larga de términos más sencillos con signos más y menos. Ningún término por sí solo es el número de listas válidas de nada; algunos son negativos; solo el total es la cuenta. Lo que ganas es que cada término se separa fácilmente en piezas independientes. Hecho a lo bruto salen demasiados términos, así que el trabajo de los dos papers está en elegir qué piezas con signo escribir, de modo que las que conectan partes lejanas del problema se cancelen.
Ese es el movimiento común. A partir de ahí los dos papers lo implementan de maneras completamente distintas.
Si solo quieres la idea, ya la tienes: el muro es que los problemas difíciles no se pueden partir limpiamente, y el camino es contar con números que pueden ser negativos, para que las partes caras se cancelen. Las dos secciones siguientes cuentan cómo lo hizo cada laboratorio, con algo más de matemáticas; puedes saltar a Qué cambia y qué no sin perder el hilo.
La ruta de Claude: una identidad de 1818
El algoritmo de Anthropic se queda con el dibujo del grafo y ataca los bits que cruzan.
Toma el grafo de cláusulas y agrupa las cláusulas en un número modesto de nodos grandes, de forma que cada par de nodos grandes esté unido por una arista que lleva el mismo número de bits. La cantidad a batir es el total de bits que cruzan, . Ahora coloca los nodos en una cuadrícula de . La mayoría de las aristas son diagonales: unen dos nodos en filas distintas y columnas distintas. Cada diagonal pertenece exactamente a un rectángulo, y cada rectángulo tiene dos diagonales: la esquina superior izquierda guarda una cadena que tiene que coincidir con la de la inferior derecha, y la superior derecha guarda , que tiene que coincidir con la de la inferior izquierda. Ese par de comprobaciones de igualdad, , es lo que el paper llama un cruce.
Si fusionas cada fila en un solo nodo, un cruce cuesta 6 bits por cada bloque de 3: la fila de arriba tiene que contarle a la de abajo tanto como . Aquí entra la identidad. Para bloques de 3 bits existe una función de signos tal que
y se puede comprobar por fuerza bruta en los 4.096 valores posibles de los 12 bits. Lee el lado derecho como dos términos. En el primero, la elección por filas, cada depende de una sola fila, y las dos filas solo tienen que ponerse de acuerdo en una cadena de 3 bits, . Eso cuesta 3 bits, la mitad de 6. El segundo término, la elección por columnas, sigue siendo caro si fusionaste filas, pero cuesta solo 3 bits si en vez de eso fusionas columnas. Ninguno de los dos términos significa nada combinatoriamente, toman valores negativos, y solo su suma es una cuenta. Pero cada término es barato en una dirección.
El resto es contabilidad, hecha con cuidado. Las cadenas se parten en bloques de 3, y la expansión se agrupa según cuántos bloques tomaron la elección por columnas, lo que mantiene polinómico el número de términos. Para cada término el algoritmo fusiona filas o columnas, lo que salga más barato. Por bloque, las dos direcciones juntas cuestan bits frente a los de dos cruces, así que la dirección más barata paga como mucho de lo que había antes. Después agrupa las filas fusionadas en supernodos equilibrados y se llama a sí mismo.
El paper escribe el tiempo como , donde es el número de bits en las aristas, proporcional al tamaño de la fórmula. Así que hace el papel de de antes, y es la base, que aquí se paga por bit en vez de por variable. Un nivel encoge en un factor . Repítelo y tiende a cero, que es lo mismo que la base tendiendo a 1: la cota del paper es . El precio es que cada nivel necesita muchísimos más nodos, empezando en 64, y por eso todo esto solo importa para fórmulas astronómicamente grandes.
La identidad es la parte bonita. En su forma clásica dice que el producto de dos sumas de ocho cuadrados vuelve a ser una suma de ocho cuadrados. Ferdinand Degen la presentó en la Academia de San Petersburgo en 1818, y John Graves la volvió a encontrar en 1843 al demostrar que la norma de los octoniones, los primos de ocho dimensiones de los números complejos, es multiplicativa. La función de signos del algoritmo es, en palabras del paper, “la tabla de signos de la multiplicación de los octoniones, con los elementos de la base renombrados”. Hurwitz demostró en 1898 que identidades así solo existen para 1, 2, 4 y 8 cuadrados. El paper tiene un apéndice que explica por qué buscar una descomposición más barata de un cruce lleva directamente al problema de Hurwitz, y por qué, con el recuento sencillo de bits que usa, solo la de ocho deja ganancia: la de dos cuadrados se queda igual, la de cuatro se queda igual, la de ocho da 11 de cada 12.
O sea, lo que ha tumbado ETH es la tabla de multiplicar de los octoniones, usada para recortar bits en una cuadrícula.
La ruta de OpenAI: deformar el problema y volver interpolando
El algoritmo de OpenAI usa la misma idea, “contar y dejar que los términos se cancelen”, pero entra por otra puerta: la interpolación.
Parte de la misma fórmula para . Ahora introduce un parámetro y sustituye cada aparición de una variable dentro de cada cláusula por una combinación lineal de variables cuyos coeficientes son polinomios en . En cada sustitución es la variable original, así que la suma deformada cumple . En los puntos , las sustituciones están diseñadas para que las variables se separen en grupos pequeños que solo interactúan a través de unas pocas “medidas” compartidas, combinaciones lineales enteras y pequeñas de los bits de cada grupo. Fija los valores de esas medidas y la suma se factoriza grupo a grupo, exactamente como lo haría la fórmula agrupada de la figura anterior. En esos puntos el problema caro se vuelve barato.
Como es un polinomio de grado conocido, sus valores y unas pocas derivadas en los puntos fáciles lo determinan por completo, y de ahí se lee . Aquí interpolar no es aproximar: es aritmética racional exacta. Toda la dificultad está en la tensión entre dos costes. Las sustituciones tienen que tener grado bajo en , o necesitas demasiados coeficientes de Taylor por punto. Y tienen que respetar una agrupación distinta en cada uno de los puntos, lo que, hecho a lo ingenuo, cuesta grado .
La construcción que lo resuelve es donde vuelve el signo menos. Está hecha de intercambios (swaps): matrices de permutación que intercambian dos etiquetas de grupo en la posición , cada una con autovalores y . Un vector de la base con de sus posiciones en el autoespacio queda multiplicado por bajo el intercambio completo. OpenAI elige un polinomio que interpola solo en una ventana corta de valores de , centrada donde una distribución binomial concentra casi toda su masa. Dentro de la ventana la construcción es exacta; las pocas direcciones que quedan fuera se pagan con medidas explícitas. La ventana solo necesita ser tan ancha como la desviación típica de la binomial, , y con de ahí sale el de la cota final.
Multiplica los tres costes (datos de Taylor, medidas, un grupo cada vez) y cada uno es . Además el algoritmo usa espacio polinómico, cosa que el de Anthropic no afirma.
El mismo muro, el mismo signo menos
Uno al lado del otro:
| OpenAI | Anthropic (Claude) | |
|---|---|---|
| Fecha del paper | 17 de octubre, revisado el 25 | 26 de octubre; núcleo encontrado el 16 |
| Extensión | 67 páginas | 49 páginas |
| Qué calcula | #k-SAT exacto, determinista | #k-SAT exacto, determinista |
| Cota, fórmulas dispersas | en el número de cláusulas | |
| Cota, cualquier fórmula | ||
| Cota demostrada en Lean | más débil: en lugar de | el teorema principal tal como se enuncia |
| Pieza clave | deformación + interpolación de Hermite; matrices de intercambio, | cuadrícula + identidad de los ocho cuadrados; recursión con factor 11/12 |
| Espacio | polinómico | no se afirma |
Las cotas caen en el mismo sitio, lo que o es una coincidencia o es una pista de dónde está la barrera natural de esta familia de técnicas. Ninguno de los dos papers sabe quitar el para fórmulas generales.
Y los mecanismos riman más de lo que parece. La construcción de OpenAI está hecha literalmente de operadores de intercambio con autovalores . El README de Anthropic condensa su propia idea clave en un párrafo que incluye “Per bit, SWAP = I − 2·singlet”, la forma de físico de escribir un intercambio como la identidad menos una corrección con signo. Los dos papers resuelven un problema más difícil para poder trabajar con cantidades con signo, y los dos sacan su ahorro de escribir el intercambio de dos cosas como una combinación de cosas más baratas con signos. El mundo no negativo, donde cada número intermedio cuenta soluciones de algo, es exactamente donde ETH era cierta.
Qué cambia y qué no
En la práctica no cambia nada. El paper de Anthropic es inusualmente directo al respecto. Para una 3-CNF con cláusulas, su cota solo mejora los de la fuerza bruta cuando , y la cota solo en , cuando . Los autores añaden que su enfoque general “parece poco probable que dé ninguna mejora general salvo que , se instancie como se instancie”, mientras que la fuerza bruta ya es imposible con . Tu SAT solver, tu planificador, tu herramienta de verificación van exactamente igual de rápido que la semana pasada.
P vs NP sigue intacto. P vs NP pregunta si problemas como 3-SAT se pueden resolver en tiempo polinómico, con un trabajo que crece como o , muchísimo más rápido que nada de lo que hay en estos papers. ETH era una apuesta más fuerte que P ≠ NP, así que perderla no dice nada de la más débil. Y una cota para 3-SAT no se traslada a todos los problemas NP, porque las reducciones en tiempo polinómico pueden inflar polinómicamente el número de variables, y compuesto con un polinomio ya no es subexponencial. Para problemas con reducciones que mantienen el tamaño lineal, sí se traslada: OpenAI obtiene conteo subexponencial de conjuntos independientes, coloraciones propias y emparejamientos perfectos; Anthropic lista Independent Set, Clique, Vertex Cover y Dominating Set en para todo .
Una estantería de teoremas ha cambiado de estado. Todo lo demostrado “bajo ETH” o “bajo SETH” ha perdido su hipótesis. Parte sobrevive sobre cimientos más débiles: las cotas inferiores cuadráticas para la distancia de edición y la subsecuencia común más larga también se siguen de la conjetura de Orthogonal Vectors, que ninguno de los dos papers refuta. Mucho de lo demás, el equivalente a unos 800 artículos, necesita ahora otra razón para ser cierto o resulta ser falso.
Y hay una ganancia de verdad incondicional. Gracias al programa de Ryan Williams, que convierte algoritmos de SAT un poco más rápidos que la fuerza bruta en cotas inferiores de circuitos, los dos papers obtienen que la clase no tiene circuitos booleanos de tamaño lineal. La versión de OpenAI da una cota inferior del orden de . Lo mejor que se conocía antes, sobre la base binaria completa, era . Las cotas inferiores de circuitos son una de las áreas más atascadas de la teoría de la complejidad, y esta ha salido como efecto secundario.
Qué comprueba Lean y qué no
Los dos resultados están formalizados, y los dos equipos tienen cuidado con lo que eso significa. El README de Anthropic lo dice en una frase que me gustaría ver en toda formalización: “Lean comprueba las demostraciones, pero ninguna máquina comprueba que este fichero dice lo que dice el paper; el fichero se mantiene corto para que un lector pueda comprobarlo.” La nota de alcance de OpenAI en Lean es igual de precisa: la cota comprobada por la máquina es la más débil, con ; la cota más fina del paper no lo está.
Ese es el hueco del que escribí en Demostrado, certificado, barrido, muestreado: un check en verde es una afirmación sobre una afirmación concreta, y el trabajo está en saber cuál. Aquí está bien resuelto. Los enunciados son cortos, están impresos en los papers y las diferencias con la prosa están listadas. Mientras escribo esto, la revisión humana sigue en marcha: según la cobertura, OpenAI ha entregado su resultado a revisores externos entre los que están el propio Impagliazzo y Paturi. Una prueba en Lean de un teorema bien enunciado les deja muy poco que encontrar, pero “bien enunciado” es justo la parte para la que están.
La demostración que cabe en un prompt
Un detalle más, y para alguien que construye con estos modelos es el que se me queda. Al final del README de Anthropic hay una sección titulada “The key idea, in condensed form interpretable by AI models”. Es un solo párrafo. Empieza con “The exponential time hypothesis is false!”, enuncia una recursión para el coste de contraer redes de tensores sobre un grafo completo, menciona la cuadrícula, el intercambio, la agrupación por número de singletes, y termina con “Prove it.” El README dice que Claude Opus 5.5 con esfuerzo alto puede volver a derivar la refutación, en su forma más débil , solo a partir de ese párrafo.
Eso es un tipo nuevo de objeto matemático. Durante siglos una demostración se ha escrito para un lector humano, con el nivel de detalle que ese lector necesite. Aquí hay tres capas: un paper de 49 páginas para personas, un desarrollo en Lean para el kernel y una pista de un párrafo para un modelo, que basta porque el modelo rellena el resto. Cuando escribí sobre la explosión de Navier–Stokes, el cuello de botella era el contrario: los borradores de la máquina eran casi ilegibles, y convertirlos en un paper que una persona pudiera seguir fueron semanas de trabajo. Siete semanas después, la descripción más comprimida de un resultado importante es la que está escrita para una máquina.
Qué me llevo
- ETH es falsa, dos veces, de forma independiente, con demostraciones formales, a falta de la revisión humana que está en marcha. SETH, Gap-ETH y #ETH caen con ella.
- El muro era el expansor, y el camino era un signo menos. Los dos algoritmos cuentan en vez de decidir, para que los términos puedan ser negativos y cancelarse. Esa es la intuición en una frase, y es la misma para los dos.
- La versión de Claude funciona con octoniones. Una identidad de 1818 sobre sumas de ocho cuadrados convierte dos comprobaciones de igualdad cruzadas en términos que son baratos cada uno en una dirección, y una recursión multiplica el exponente por 11/12 en cada nivel hasta dejarlo tan pequeño como quieras.
- La versión de OpenAI deforma e interpola. Un polinomio que vale la cuenta en 0 y se separa en grupos independientes en , sostenido por matrices de intercambio y por un polinomio que imita en una ventana bajo una campana de Gauss.
- Ninguna consecuencia práctica. El punto de cruce está más allá de variables. Las consecuencias son para la teoría: cientos de cotas inferiores condicionales pierden su hipótesis, y una cota inferior de circuitos se ha movido gratis.
- Dos laboratorios, la misma semana, la misma cota. Diga lo que diga esto sobre el problema, dice algo sobre los modelos: la frontera de lo que pueden encontrar incluye ya un resultado al que uno de los mayores expertos del campo, en 2019, daba un 70 a 30 en contra.
Fuentes: el paper y la formalización en Lean de Anthropic (A 2^o(n) Time Algorithm for 3-SAT, por Claude), y la nota de alcance en Lean y el paper de OpenAI (The Exponential Time Hypothesis is False).
Sobre la identidad de los ocho cuadrados y los octoniones: John C. Baez, “The Octonions”, Bulletin of the AMS 39 (2002), 145–205; J. H. Conway y D. A. Smith, “On Quaternions and Octonions”, A K Peters, 2003; A. Hurwitz, “Über die Composition der quadratischen Formen von beliebig vielen Variabeln”, Nachr. Ges. Wiss. Göttingen (1898), 309–316; y la identidad de los ocho cuadrados de Degen en Wikipedia.