Los huecos del mapa no son ideas
En este artículo
Hace poco @syntheticbeef publicó en X una receta para que la IA invente ideas de verdad nuevas. Embebes los juegos de Steam, eliges puntos del espacio que estén lejos de todos ellos, conviertes cada punto de vuelta en la descripción de un juego y ordenas el resultado por lo distinto que es de lo que ya existe. Si el punto está lejos de todo, la idea que sale de él debería ser nueva.
Mi objeción fue inmediata: en un espacio de mil dimensiones casi todo está lejos de todo, y casi todo ese espacio es ruido. Que un punto esté vacío no significa que ahí quepa una idea; puede que ahí no quepa ningún texto con sentido. Un amigo me respondió que la coherencia es otra dimensión más, con sus propios óptimos locales, y que la difusión de imágenes demuestra que existen rincones raros y con sentido: un astronauta a caballo. Le di la razón en que existen, pero la difusión llega a ellos partiendo de un concepto y avanzando por similitud; el tuit busca la disimilitud sin ningún punto de partida.
Era una discusión que se podía medir, así que la medí.
Tres mapas
Repetí todo en tres catálogos que no se parecen en nada entre sí, para que la conclusión no dependiera de uno:
- Steam, el mapa del tuit: unos 68.000 juegos publicados antes de 2024, con su descripción, géneros y etiquetas. Guardé aparte los 41.000 publicados después, para comprobar al final si alguna idea se adelantaba a lo que salió más tarde.
- arXiv: 72.000 artículos de informática anteriores a 2023, cada uno con su título y su resumen.
- Patentes: 71.521 solicitudes de patente presentadas en Estados Unidos entre 2012 y 2015.
Steam es el hilo del artículo. arXiv y patentes sirven para comprobar que lo que pasa no es una rareza de los videojuegos.
Cada texto se convierte en un vector con Qwen3-Embedding-0.6B, un modelo abierto de embeddings. Para medir lo cerca que están dos textos uso el coseno entre sus vectores: 1 si apuntan en la misma dirección, 0 si no tienen nada que ver.
Dos formas de convertir un punto en texto
Un punto del espacio es una lista de 1.024 números. Ningún modelo de lenguaje puede leerlo, así que el tuit da por hecho un paso que no es trivial: convertir el punto de vuelta en texto. Hay dos formas de hacerlo.
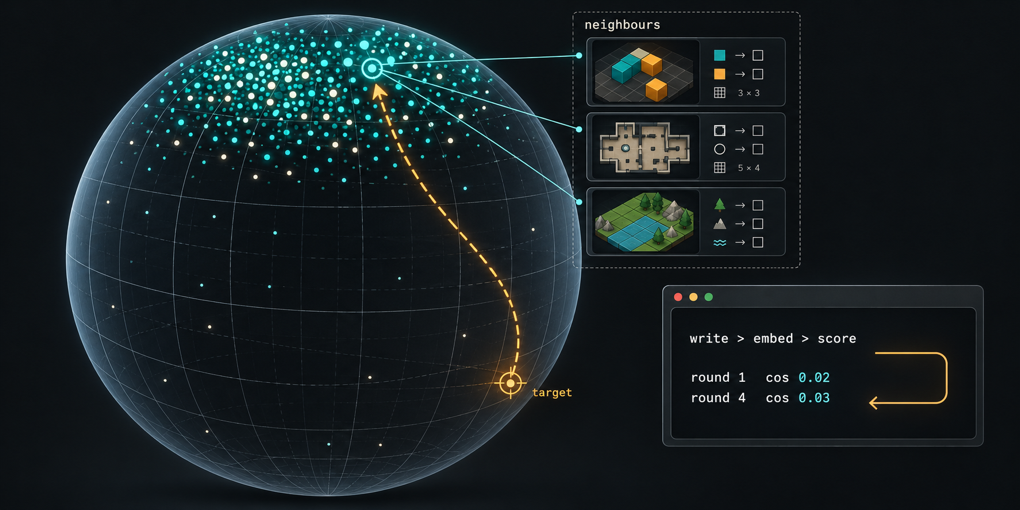
La primera es enseñarle los vecinos, la que se le ocurre a cualquiera. Le enseñas al LLM los 8 juegos reales más cercanos al punto, le pides una ficha de juego y le dices lo cerca que ha quedado: el coseno entre su ficha y el punto. Con esa nota vuelve a intentarlo, como en el juego de frío o caliente. Cuatro rondas de tres candidatas, y me quedo con la mejor. En arXiv el LLM escribe un resumen de artículo, y en patentes, una solicitud.
Esta forma tiene un problema evidente. Si le das 8 juegos, lo normal es que escriba algo parecido a esos 8, y entonces el punto sobra: es lo mismo que pedirle «hazme un juego a partir de estos». Lo único que podría hacer que el punto importara es la nota de coseno. Si el frío o caliente funcionara, el LLM se iría acercando al punto más allá de lo que le dan los vecinos. Eso se puede medir, y lo medí.
La segunda forma es buscar sin enseñar nada. Una búsqueda en GPU genera textos que maximizan directamente el coseno con el punto. Esos textos se acercan mucho, pero son sopa de palabras, así que luego Claude o Codex los reescriben para que se puedan leer, con el coseno como única pista. Dos modelos tienen que aceptar el resultado como coherente. Esta es la prueba de verdad de la idea del tuit: si hay un texto coherente cerca del punto, es la forma que tiene más opciones de encontrarlo.
Cinco tipos de punto
Probé cinco tipos de punto. Cada tipo es lo que en un experimento se llama un brazo:
- REAL: el punto de un juego real que escondo del mapa. Es el control. Si el método no recupera un juego que existe, nada de lo demás significa algo.
- INTERP: el punto medio entre dos juegos muy distintos. Es la versión geométrica de «combina dos ideas lejanas».
- GAP: huecos internos, puntos que caen en la zona donde hay juegos pero donde no hay ninguno.
- FAR: la receta del tuit. De 20.000 direcciones al azar, las 50 más alejadas de cualquier juego.
- PLAIN: sin mapa. Solo le pido al modelo «inventa un juego nuevo, distinto de cualquiera que exista».
En Steam usé seis generadores, que son los modelos que escriben las fichas: Claude Opus, Sonnet y Haiku, gpt-6.1-sol, y gpt-6-luna por API y a través de Codex. En arXiv y patentes usé dos, luna vía Codex y Sonnet. Antes de puntuar, otro modelo reescribía cada ficha al mismo formato de 120 palabras, para que el estilo no delatara de dónde venía. Después cuatro modelos distintos las puntuaron a ciegas en coherencia, viabilidad, atractivo y novedad frente a los cinco textos existentes más parecidos. Entre las fichas a puntuar había también juegos reales posteriores a 2024, como referencia. Además, yo puntué 64 de las mismas fichas a mano.
Qué sale enseñando los vecinos
REAL funciona. Cuando el punto es un juego escondido, el decodificador vuelve a su zona, con un coseno de alrededor de 0,7. Con Star Farmer: Warlock of the Universe escondido, escribió Voidbloom Run, un juego de granjero espacial que cultiva semillas en planetas hostiles, a 0,87.
Y reconstruye lo que haya en el mapa, también lo que nadie querría. Uno de los juegos escondidos era SEX with HITLER: WW2, y entre los vecinos que vio el modelo estaban los dos anteriores de la serie, SEX with HITLER y SEX with HITLER 2. Escribió Hitler: No Future in Berlin, una novela visual con disparos en la que el Führer, derrotado, intenta sobrevivir entre las ruinas de Berlín y conoce a «cinco heroínas adultas» (coseno 0,69).
INTERP da combinaciones literales. Entre Skill Master VR — Learn Meditation, un juego de meditación en realidad virtual, y Demon’s Rise - Lords of Chaos, uno de estrategia con demonios, salió Ashen Breath: Legions of the Void, un RPG táctico de fantasía oscura «con un modo opcional de meditación en VR» (0,84). Es lo que se pidió, y se nota la costura.
FAR no llega a ninguna parte. La ficha aterriza a un coseno de entre 0,03 y 0,05 del punto, según el generador, es decir, prácticamente a cero. El juego existente más cercano a esos puntos está a 0,046, así que tampoco hay nada mejor. Lo que sale es un juego normal, parecido a los vecinos que se le enseñaron. Los de uno de los puntos eran Challenge from the Black Cat, un puzle japonés de hámsteres y My Furry Stepmom, y salió Pounce & Pop: Kitten’s Block Quest, una gatita que empuja bloques para volver a casa (0,069). De otro salió The Museum of Unfinished Things, un museo que se reordena solo por la noche (0,028). Son juegos razonables, incluso agradables, que podrían estar ya en Steam.
En arXiv y en patentes pasa lo mismo: lo que se escribe para un punto FAR aterriza a menos de 0,08.
¿Es solo copiar a los vecinos?
Las fichas FAR estaban mucho más cerca de sus 8 vecinos que del propio punto: en Steam, a un coseno de 0,63–0,72 de su centroide, frente a 0,03 del punto. Pasaba en el 100 % de las fichas FAR de los tres catálogos. La pregunta del apartado anterior seguía abierta: ¿la nota de coseno aporta algo, o todo lo hacen los vecinos?
Para separarlo hice una prueba causal. Mismo punto, misma nota de coseno, y solo cambio una cosa: los vecinos que ve el LLM. Pueden ser los verdaderos, los de otro punto distinto, o ninguno. La hice en Steam y en arXiv, con dos generadores (luna y Sonnet), en REAL, GAP y FAR, con 20 puntos por combinación y las reglas de decisión escritas antes de lanzar nada.
Lo hacen los vecinos, en las 12 combinaciones. Con los vecinos de otro punto, la ficha se va hacia ese otro punto. Sin vecinos, jugando solo a frío o caliente, la ficha acaba entre 0,04 y 0,07 más cerca de su punto que de otro punto cualquiera del mismo tipo. Hasta con un juego escondido, sin vecinos se queda en 0,36–0,47, cuando con ellos llega a 0,7–0,8.
Visto ahora parece obvio, y en parte lo es: si a un LLM le das 8 juegos, escribe algo que depende de esos 8, no de un punto del que no sabe nada. Pero eso es lo que hace cualquier decodificador que use un LLM de esta manera, así que cualquier «idea» que salga de un punto por este camino es una mezcla de sus vecinos. Para saber si en el punto hay algo, hay que buscar sin vecinos.
Buscar sin vecinos
Antes de mirar los puntos lejanos comprobé que la búsqueda funcionaba. Con los juegos y artículos escondidos de REAL, el mejor texto coherente quedó más cerca del punto que cualquier texto existente en los 10 casos de cada catálogo. En la mayoría de los huecos GAP llegó a la altura de lo existente o algo más allá.
En los puntos FAR la cosa cambia. En arXiv mi objeción se sostiene: en el 90 % de los puntos, el mejor texto coherente no supera al artículo existente más cercano. En Steam, no del todo. En un 25 % de los puntos el texto coherente sí queda más de 0,05 por encima del juego más cercano, y en un 15 % si exijo además el visto bueno de un tercer modelo que no había escrito ni filtrado nada de lo que juzgaba. Salir un poco más allá de lo que existe es posible.
Pero hay que mirar la escala. Esos textos que escapan se quedan a un coseno de 0,09–0,14 de su punto, cuando el punto mismo está en 1. «Más lejos que cualquier juego» no es «en el punto». Esto matiza mi objeción, y creo que la mejora. No es imposible salir del mapa. Lo que pasa es que lo que se alcanza queda muy lejos de lo que se pidió, y lo que se lee sigue siendo un juego normal.
Por qué: el casquete
La geometría explica por qué los puntos lejanos son inalcanzables. Los textos no se reparten por todo el espacio. Todos comparten una dirección común, así que ocupan un casquete estrecho de la esfera: dos juegos cualesquiera de Steam tienen un coseno de 0,41, mientras que dos direcciones al azar tienen 0 ± 0,03. Los puntos FAR son direcciones al azar elegidas por estar lejos de todo, así que caen fuera del casquete. Cualquier texto, por raro que sea, cae dentro.
Con esta geometría se puede predecir la distancia antes de mirar. Antes de construir ningún punto de arXiv, calculé solo con las estadísticas del corpus a qué distancia quedaría el artículo más cercano a un punto lejano. Predije 0,062 y salió 0,058. En patentes salió 0,062.
Lo que sí funciona: pedirlo sin mapa
Los huecos internos sí se alcanzan, pero no son más nuevos. En Steam los jueces les dieron una novedad de 4,9 sobre 10, por debajo de INTERP (5,5), con los seis generadores. En arXiv quedaron empatados con INTERP, y en patentes depende del generador. Un hueco entre juegos se rellena con algo que se parece a los juegos de alrededor.
Para los jueces, lo más novedoso fue lo que no usaba el mapa: PLAIN, simplemente pedir «un juego nuevo». Con todos los generadores, PLAIN superaba al mejor brazo guiado por entre 1,1 y 2,6 puntos de novedad.
Hasta que leí las fichas seguidas. Sonnet llamó a 45 de sus 50 juegos «Tidewright» algo, y luna vía Codex escribió 46 museos de 50. Yo lo vi enseguida («otro museo… cansino»). Los jueces no lo vieron, porque puntuaban cada ficha por separado y nunca vieron dos juntas. Cada idea era nueva frente al catálogo, pero el generador repetía siempre la misma idea. En arXiv pasó igual: Sonnet tituló 43 de sus 50 artículos «Tidal» algo.
Lo arreglé con una variante, PLAIND, en la que el modelo ve los títulos que ya ha propuesto. La repetición baja casi al nivel de los brazos guiados y la novedad sigue siendo la más alta en los tres catálogos, entre 1 y 5 puntos por encima de INTERP según el generador.
Mi novedad y la de los jueces no se parecen tanto como esperaba.
En Steam coincidimos salvo en PLAIN, por los museos repetidos. En patentes soy mucho más duro en todos los brazos. De tres de las cuatro patentes FAR que leí dije «sí, conozco algo que hace esto», y de una GAP escribí que era «un recommendation system de toda la vida». Creo que medimos cosas distintas. Los jueces premian lo específico y poco familiar frente a los cinco textos que se les enseñan, y yo me pregunto si el concepto ya existe.
¿Se puede demostrar?
Quise ir más allá de los datos y, con ayuda de gpt-6-astra, intenté demostrar una cota: hasta dónde puede acercarse un texto coherente a un punto lejano. Ninguna cota aguantó, porque cada propuesta caía con los datos que ya teníamos. La coherencia no es suave: los jueces dan veredictos opuestos a fichas que solo se diferencian en una palabra. Y ningún umbral de probabilidad de un modelo de lenguaje separa lo que los jueces aceptan de lo que rechazan.
Así que le di la vuelta: ¿se puede demostrar que no hay cota? En sentido estricto no, porque los textos de longitud limitada son un conjunto finito y siempre tienen un máximo. Lo que sí quedó demostrado, y comprobado en Lean, es otra cosa. Sin una regla que diga qué cuenta como coherente, nadie puede certificar un techo mejor que el trivial, por muchas pruebas que haga. Y en general, el problema es computacionalmente difícil.
¿Se adelantó alguna idea al futuro?
Quedaba la comprobación con los juegos y artículos posteriores. En Steam no sirve: una vez reescritas todas las fichas al mismo formato, los juegos reales anteriores y posteriores a 2024 apenas se distinguen. En arXiv sí funciona, y las ideas FAR no se acercan a lo publicado después de 2023 más que un artículo antiguo cualquiera. Las de PLAIND sí se acercan. Pero los generadores se entrenaron después de 2023, así que eso muestra que saben lo que vino, no que lo anticipen. El único generador que no podía conocer esos artículos, gpt-4o, no se adelanta a nada una vez quitado el estilo.
En resumen
- Decodificar un punto con un LLM es mezclar sus vecinos. La nota de coseno casi no aporta nada; lo que sale depende de lo que se le enseña.
- Buscando sin vecinos, los puntos lejanos siguen sin alcanzarse. Lo mejor que encontré se queda a 0,14 de un punto que está en 1, porque los textos viven en un casquete y esos puntos están fuera.
- Los huecos internos se alcanzan, pero no son nuevos. Se rellenan con algo parecido a lo que los rodea.
- La novedad vino de pedirla, no de la geometría vacía, siempre que el modelo vea lo que ya ha propuesto.
El tuit acierta en algo: hay rincones del mapa sin explorar a los que se puede llegar. Pero un punto lejos de todo no es una idea esperando a que alguien la escriba. Casi siempre es un sitio donde no cabe ningún texto.
Me queda la otra mitad de la pregunta, la que el resultado de arXiv deja abierta: ¿puede un modelo llegar a una idea que de verdad no existía cuando se entrenó? Es la prueba de Einstein que propuso Demis Hassabis: entrenar un modelo solo con lo que se sabía antes de 1911 y ver si llega a la relatividad general. Esa será la segunda parte, con un generador cuya fecha de corte controlo yo.
El código, los preregistros y las demostraciones en Lean están en github.com/JaviMaligno/latent-gap-ideas.