Jev: cuánto sobrevive al hype
En este artículo
En uno de los sistemas con los que trabajo, un modelo lee facturas y extrae precios, importes y otros campos. Después necesito comprobar algo bastante más pequeño: ¿ese dato aparece realmente en la factura? Para responder, no necesito que otro modelo escriba un informe. Necesito una decisión.
Ese es el hueco en el que entra Jev, de TypeSafe. Le doy información y una pregunta con respuestas acotadas; me devuelve una categoría, una puntuación o una probabilidad. La promesa es resolver ese tipo de decisiones mucho más rápido y barato que un modelo generativo grande.
Jev acaba de salir y tiene bastante hype. Yo quería saber cuánto sobrevivía al probarlo en cosas que hago de verdad. Lo he usado en tres niveles: mi trabajo con agentes, los productos que desarrollo y los entornos donde tendría que desplegarlo. En cada uno he encontrado una frontera distinta.
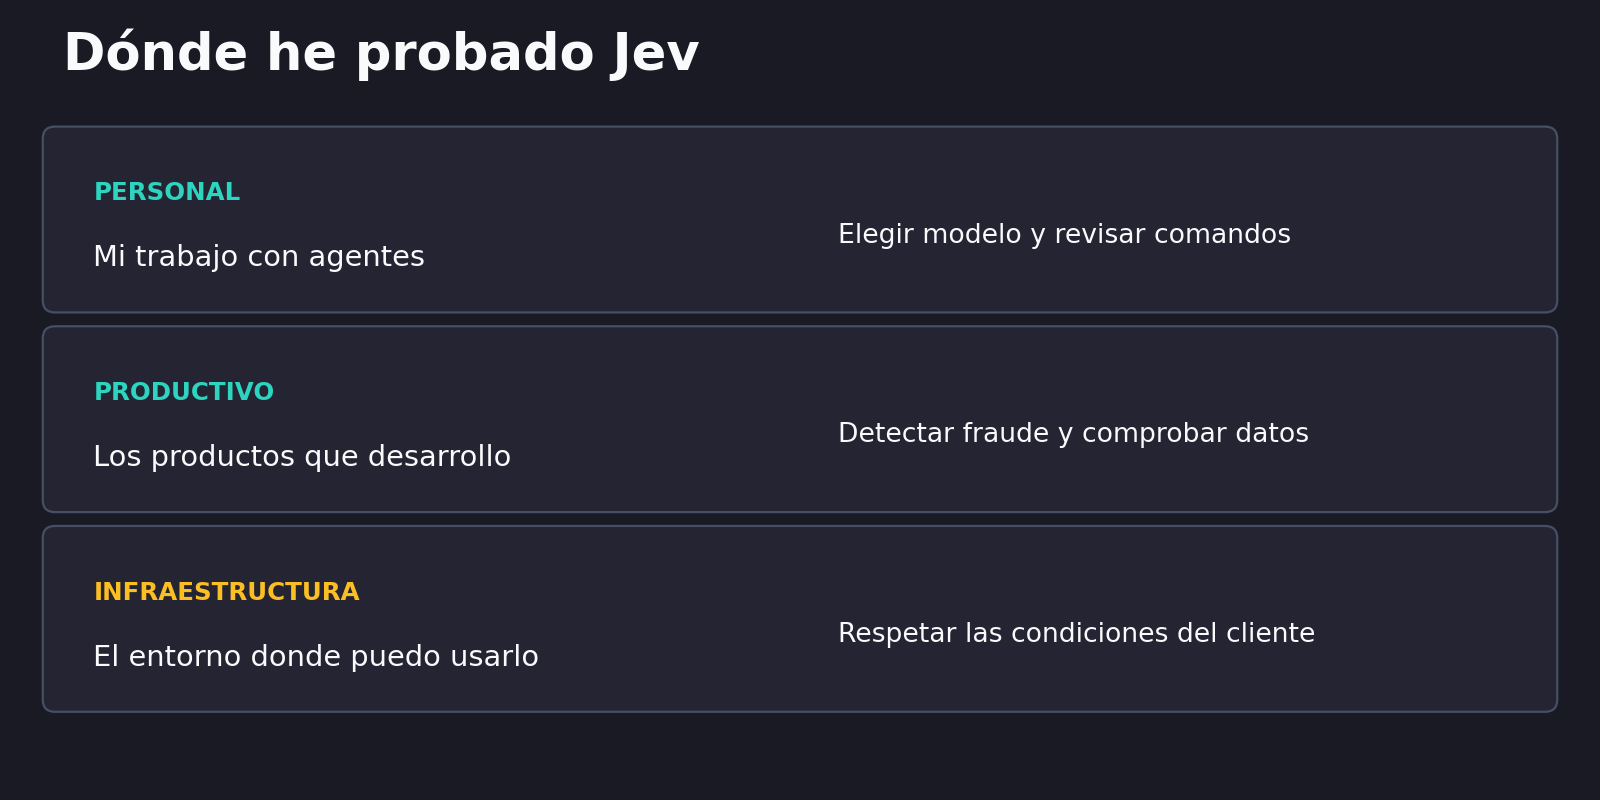
Personal: ayudarme a trabajar con agentes
Cuando uso Claude Code o Codex, no todas las tareas necesitan el mismo modelo. Encontrar un archivo es distinto de revisar un cambio de autenticación. También hay decisiones antes de ejecutar comandos: leer un fichero, borrar datos o desplegar una aplicación tienen consecuencias diferentes.
En Claude Code he conectado Jev a esos dos momentos. Recomienda qué nivel de modelo usar para una tarea y valora el riesgo de los comandos. Lo tengo en sombra: registra qué habría recomendado, mientras la decisión real sigue en manos del agente y mías.
En una primera prueba con tareas inventadas distinguió bien los ejemplos claros: búsquedas y cambios mecánicos por un lado, trabajo de arquitectura o seguridad por otro. Consultarlo costó una fracción de céntimo. Eso me permite recoger recomendaciones a bajo coste; para saber si elegir modelos más baratos compensa, tengo que medir también si terminan bien el trabajo y cuántas veces hay que repetirlo.
En Codex hice una comparación con trabajo real del agente sobre un proyecto de prueba: corregir un error de paginación y otro en el cálculo de un descuento. Ejecuté cada tarea con el mismo modelo, primero en una condición y luego en la otra: con Jev y sin él. Para la versión con Jev, lo conecté como una herramienta que Codex consultaba antes de usar la terminal.
Codex resolvió bien las dos tareas en ambas condiciones. Pero en estas ejecuciones, consultar a Jev llevó la duración a aproximadamente el doble. Las llamadas a Jev costaron una fracción de céntimo; el trabajo adicional estaba en los intercambios que el agente necesitaba para pedir y leer cada evaluación.
Es una prueba pequeña, pero me dio un resultado concreto: añadir una opinión antes de cada lectura o test no mejoró esas correcciones y sí las hizo más lentas. Esa integración me sirve para experimentar; todavía no me aporta una mejora en ese flujo.
La diferencia entre esos dos usos me parece importante. Elegir bien un modelo puede ahorrar una tarea cara. Consultar por cada paso añade trabajo incluso cuando la respuesta era obvia. Ahora mismo veo más interés en reservar Jev para decisiones que cambian lo que voy a hacer.
Productivo: detectar engaños y comprobar datos
SMS: distinguir un aviso legítimo de una estafa
Uno de los sistemas en los que trabajo analiza mensajes SMS para detectar intentos de fraude: mensajes que suplantan a una entidad y buscan que el destinatario abra un enlace, entregue sus credenciales o haga un pago.
Probé la integración de Jev con 80 mensajes en español, mezclando mensajes legítimos y fraudulentos. El sistema completo clasificó correctamente 78 de esos 80. Los dos errores fueron estafas que dejó pasar; no marcó como fraude ningún mensaje legítimo de la prueba.
Al revisar los dos fallos encontré dónde mejorar. Un mensaje quedó justo por debajo del umbral que activa una alerta al combinar las puntuaciones. El otro se remitió al detector anterior porque la respuesta de Jev no daba suficiente certeza, y ese detector lo dejó pasar. La prueba me señaló dos ajustes concretos: cómo combinar la valoración de Jev con las demás señales y qué revisión dar a los mensajes dudosos.
Facturas: comprobar es distinto de preguntar «¿estás seguro?»
En facturación, mi pregunta era si Jev podía encontrar errores en los datos extraídos por otro modelo. Le pasé el texto de la factura y los valores que quería comprobar.
La comprobación resultó mucho más útil que la confianza que el propio extractor decía tener. Encontré valores erróneos o que no estaban en el documento a los que el extractor había asignado una confianza altísima. Jev, al contrastarlos con el texto, sí señalaba muchos de esos problemas.
El límite estaba en lo que yo llamaba «error». Un campo puede estar bien aunque el extractor haya normalizado el formato o unido información de varias partes del documento. En la primera prueba, aproximadamente la mitad de los avisos de Jev eran falsas alarmas. Afinar qué debía comprobar mejoró la utilidad de la revisión.
Ahí sí veo una pieza aprovechable: un segundo lector barato que señale campos sospechosos para revisarlos. No daría por incorrecto cada campo que marque.
Correo: decidir cuándo hace falta el análisis caro
En el análisis de correo ya tenía una segunda revisión con Sonnet para mensajes sospechosos. Probé a poner Jev delante: que resolviera los casos claros y dejara los dudosos para Sonnet.
En el conjunto de prueba, Jev resolvió el 56 % de los correos sin necesitar esa segunda llamada. No observé errores en los casos que resolvió por su cuenta. El coste estimado de esa etapa bajaba de unos 11,90 a 5,30 dólares por cada mil correos.
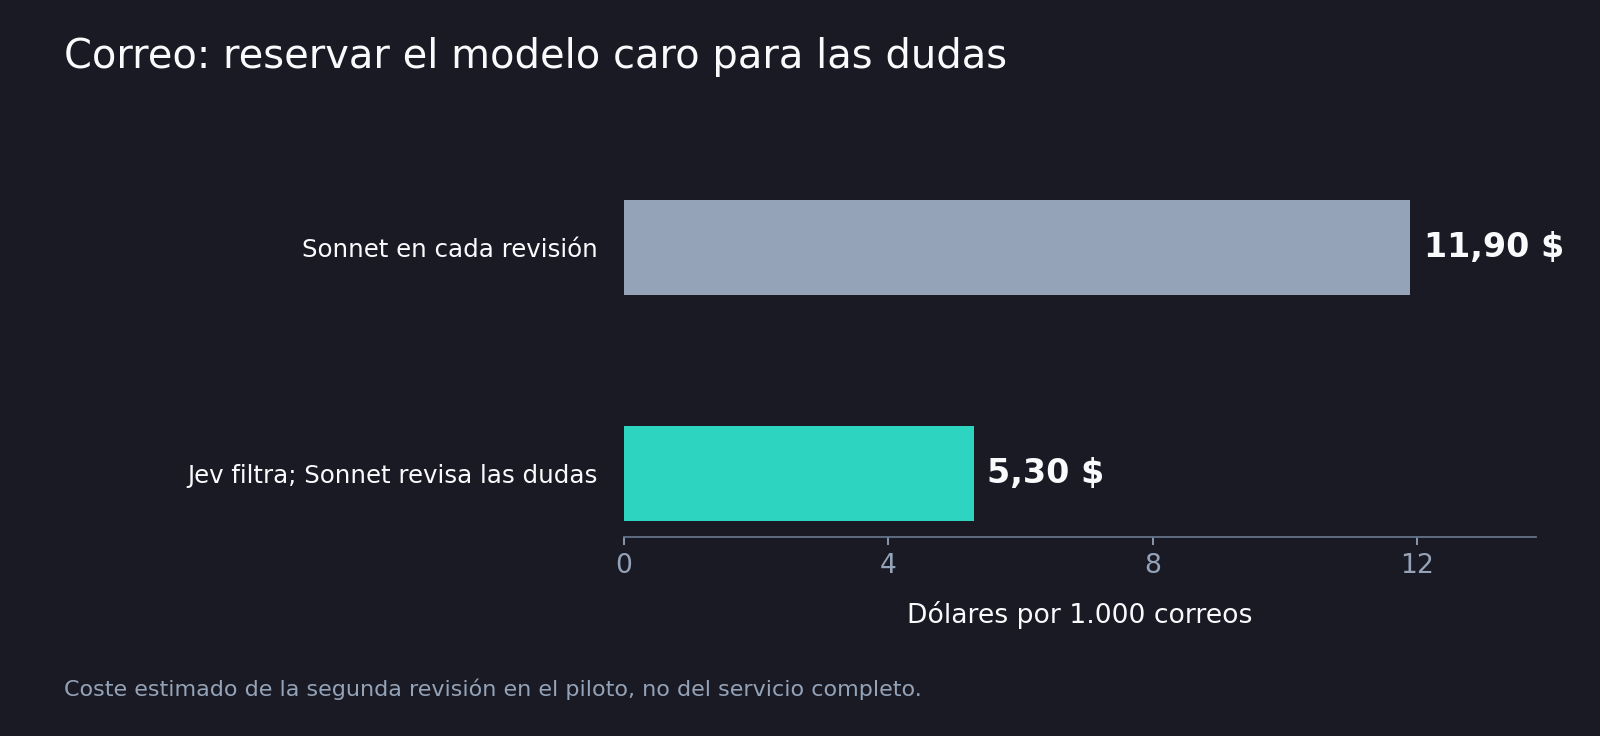
Ese es un ahorro que puedo relacionar con una decisión concreta: evitar llamadas caras que no hacen falta. La prueba incluía ataques reconstruidos, así que me sirve para justificar una evaluación con tráfico real, no para asegurar que detectará cualquier campaña nueva.
También probé Jev para revisar transacciones sospechosas. En una prueba con veinte fraudes simulados detectó diecisiete, los mismos que Haiku, y produjo las mismas falsas alarmas sobre las operaciones legítimas. Lo hizo más rápido y a menor coste. Es un resultado prometedor para esa segunda opinión, con la limitación evidente de que los fraudes eran simulados.
Dónde no me aportó lo suficiente
No todo lo que parece una clasificación mejora por ponerle Jev.
Lo probé para elegir el material correcto entre candidatos de un catálogo y no recuperó las correcciones humanas que buscaba. En dominios fraudulentos con una letra cambiada dejó pasar casos que el modelo anterior sí detectaba. Y al elegir herramientas para un chatbot, las descripciones ambiguas de las herramientas seguían provocando elecciones equivocadas.
También evalué si podía decidir qué comentarios de usuarios debían convertirse en tickets. Crear un ticket innecesario es molesto; descartar un problema real puede dejarlo invisible. La prueba no contenía suficientes ejemplos de ese segundo riesgo. Me interesa usarlo para proponer tickets, pero no tengo evidencia para dejarle descartar reportes automáticamente.
Mi lectura es bastante concreta: funciona mejor cuando le doy la evidencia necesaria y las opciones están bien definidas. Si el catálogo es ambiguo o falta información, un modelo barato sigue teniendo un problema mal planteado.
Infraestructura: los casos que funcionan y aun así no puedo desplegar
Mi clasificador de actividad económica investiga a qué se dedica una empresa y le asigna una categoría. Dentro de ese proceso hay varios pasos de clasificación y verificación de fuentes donde probé Jev. Mi experiencia fue que obtenía resultados equivalentes a GPT‑5.6 Luna, más rápido y barato.
Aun así, la política de datos limitó su adopción. Me ocurrió algo parecido en los pilotos industriales: el entorno del cliente exigía una vía aprobada en Azure Foundry, y la integración que estaba probando no cumplía ese requisito.
Es una frontera fácil de olvidar cuando miro una tabla de resultados. Puedo demostrar que un modelo hace bien una tarea y seguir sin poder enviarle los datos con los que tendría que hacerla.
La política de TypeSafe indica que el servicio está alojado en Estados Unidos. Ofrece un acuerdo de tratamiento de datos, se compromete a no entrenar con datos del cliente sin consentimiento y tiene retención cero para clientes enterprise. Ninguna de esas condiciones sustituye el requisito de procesar en una región o un proveedor concretos.
Usar OpenRouter tampoco resuelve eso por sí solo: tengo que comprobar las condiciones del proveedor que procesa la petición.
Hay otros límites que sí puedo resolver en el diseño. Si necesito sumar importes o comparar fechas, lo hago en código. Jev está pensado para juicios sobre texto y su propia documentación advierte de dificultades con cálculos, contexto irrelevante e instrucciones engañosas. Le paso solo lo que necesita y conservo una alternativa cuando falla o no ofrece una respuesta suficientemente clara.
Qué me queda del hype
Jev no me ha cambiado la vida, pero ha hecho algunas partes de mi trabajo más rápidas y baratas.
Me queda una herramienta útil para algunas decisiones pequeñas que estaba pagando como si necesitaran un modelo grande. La comprobación de documentos y el filtro antes de un análisis caro son los casos que más me convencen. En mi trabajo con agentes todavía estoy buscando dónde compensa añadir esa consulta.
Mi apuesta es que OpenAI, Anthropic, Google u otros acabarán ofreciendo modelos comparables de clasificación one shot. Me parecería lógico: muchas aplicaciones necesitan elegir entre unas pocas opciones con rapidez y a bajo coste.
Si aparecen, querré compararlos en estas mismas decisiones. Lo que me interesa conservar son las preguntas, las pruebas y los criterios para decidir cuándo fiarme. Jev ha pasado una parte de esas pruebas. En otras prefiero mantener lo que tenía, y en algunas el límite lo pone el entorno en el que trabajo.