Nadie le cuenta el porqué al que implementa
En este artículo
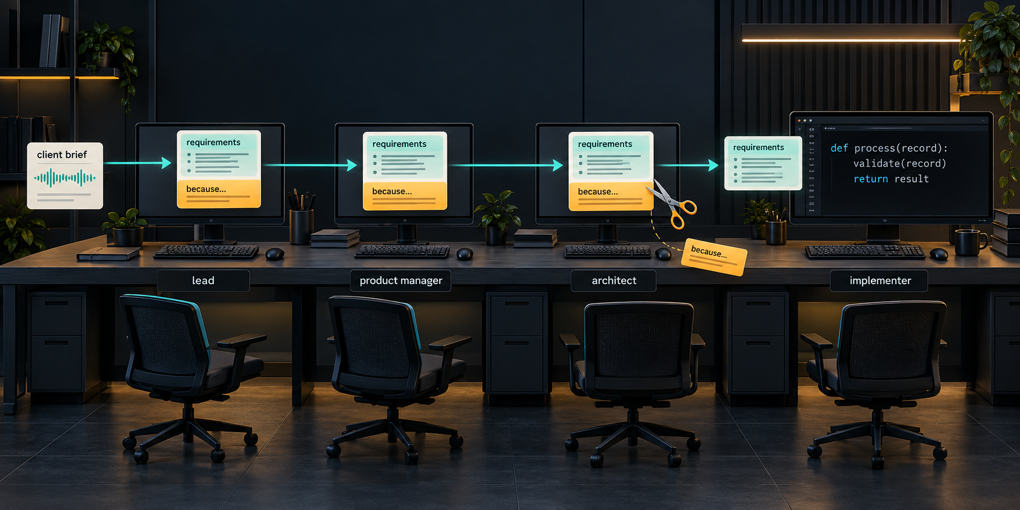
Mucho de lo que pido a mis agentes lo dicto, y el transcriptor tiene debilidad por los nombres. «Siobhán» sale como otra cosa, y nada en el resto del mensaje permite recuperarlo. Cuando ese encargo pasa después a un agente lead, que se lo pasa a un product manager, que se lo pasa a un arquitecto, que se lo pasa a quien escribe el código, quería saber dos cosas: qué llega al final de la cadena y si los agentes añaden ruido propio por el camino.
Es el juego del teléfono roto, jugado con agentes. Pero no quería la versión artificial, con diez agentes en fila susurrándose. En montajes reales un mensaje rara vez cruza más de tres o cuatro agentes, y cuando lo hace es porque hay una jerarquía: un lead y roles por debajo. Así que eso es lo que medí.
El montaje
Seis encargos de cliente, tres de software y tres de una agencia de eventos. Los de software piden un módulo pequeño de Python (recordatorios de citas para una óptica, prorrateo de asientos en una factura SaaS, un proceso de purga RGPD). Los de eventos piden un plan: una jornada de empresa, una boda hispano-finlandesa, un congreso científico. Cada encargo está escrito como habla un cliente y contiene hechos de varios tipos, etiquetados de antemano: nombres, números, prohibiciones, condiciones, prioridades, detalles fáciles de pasar por alto y motivos («porque el campo antiguo dejó de actualizarse tras la migración del CRM en marzo»).
Dos formas de equipo, las dos realistas:
Los equipos de eventos tienen tres roles (gestor de cuenta, logística y proveedores) en vez de cuatro, así que su cadena tiene un salto menos.
Cada mensaje entre agentes salía en uno de tres formatos: prosa libre, una lista numerada de requisitos, o una nota breve con el encargo original del cliente adjunto palabra por palabra. El encargo original venía en cuatro versiones: limpio, o con un error de transcripción de un tipo distinto (un nombre destrozado, un homófono, o una puntuación que cambia el sentido: «No, hazlo así» frente a «No hazlo así»).
Los modelos fueron Claude Haiku 5.5 y Sonnet 5.5, como subagentes anidados de verdad en Claude Code, y GPT-6 Luna en un harness propio que pasa los mismos mensajes de rol en rol. Tres repeticiones por celda: 853 corridas válidas de Claude y 432 de Luna. Cada mensaje se puntuó hecho a hecho como conservado, perdido, distorsionado o invertido: nombres y números con comprobaciones deterministas, el resto con un juez de otra familia que los agentes: GPT-6.1 Sol (a través de Codex) para las corridas de Claude, y Claude Opus 5.5 para las de Luna. El artefacto final, el código o el plan, pasó por tests ocultos que comprueban cada requisito.
Casi todo llega
La mayor parte del encargo sobrevive al viaje. En el salto 4, en las corridas de Claude, las prohibiciones llegan intactas el 98 % de las veces, los detalles fáciles de pasar por alto el 96 %, los números el 92 %, los nombres y las condiciones el 90 %, las prioridades el 85 %. Luna está en el mismo rango: 91-99 % en todo salvo en un tipo.
Ese tipo son los motivos.
El porqué no se desgasta. Se recorta
En la cadena de Claude, el motivo de una decisión viaja bien durante dos saltos: 88-99 % en el mensaje del lead al PM, 83-97 % del PM al arquitecto. Después el arquitecto escribe al implementador, y cae al 8-31 %.
La lectura obvia sería la distancia: cuatro saltos, cuatro ocasiones de perder algo. El relevo la descarta. Ahí el lead escribe él mismo el salto 4, con el encargo del cliente delante, y solo conserva el motivo en el 24 % de sus mensajes al implementador, tanto con Haiku como con Sonnet. Tiene la información; decide no pasarla.
Así que no es un efecto de teléfono roto en el sentido de algo que se desgasta de boca en boca. Es una decisión sobre la audiencia: quien escribe a quien construye escribe instrucciones, y las instrucciones no llevan motivos. Luna hace lo mismo, solo que antes: quita el motivo desde el primer mensaje (lo conserva en el 30 % de sus mensajes al PM) y se queda bajo hasta el final.
En los equipos de eventos el recorte es más suave. El responsable de proveedores, que reserva el catering y escribe el plan, sigue recibiendo el motivo el 75-84 % de las veces en la cadena de Claude, y el 40-64 % cuando el lead le escribe directamente en el relevo. El ejecutor que escribe código es el que menos lo oye.
¿Importa perderlo?
Esa fue mi siguiente pregunta, y la respuesta es menos limpia de lo que esperaba. Dentro de cada regla, formato y modelo, comparé las corridas en las que el motivo llegó al implementador con las que no, y miré si el artefacto final cumplía la regla. Con Claude, conservar el motivo no ayudó: las reglas se cumplían algo menos cuando su motivo llegaba (10 puntos menos, intervalo del 95 % de −15 a −5). Con Luna la diferencia va al revés, +9 puntos, pero el intervalo cruza el cero.
El efecto negativo en Claude se concentra en Haiku y en reglas cuyo motivo nombra lo antiguo. «La inactividad se mide con last_seen_at, no con last_login, porque la app móvil dejó de actualizar last_login»: con ese motivo en el mensaje, Haiku usó el campo correcto el 59 % de las veces; sin él, el 97 %. Mi hipótesis es que el motivo vuelve a meter el nombre equivocado en el mensaje y hace de distractor. Este análisis no estaba planeado antes de las corridas, así que lo tomo como hipótesis, no como conclusión. Pero basta para no afirmar que siempre merece la pena llevar el porqué.
Lo que sí importa, y claramente, es perder el requisito en sí. En las corridas de Claude, un hecho que llegó intacto al implementador se cumplía en el artefacto final el 95 % de las veces; uno que se perdió por el camino, el 40 %. Las pérdidas son raras, pero cada una se nota en el resultado.
Los nombres se congelan; la puntuación se repara
Los errores de transcripción se comportan de forma muy distinta según el tipo.
Un nombre destrozado no se puede reparar a partir del texto: nada en el encargo dice cómo se escribe «Siobhán». Pero sí se puede cuestionar, como haría una persona: «¿seguro que el nombre es este?». Casi nadie lo hizo. En los traspasos de Claude, menos del 2 % de los mensajes que llevaban un nombre destrozado lo marcaron como dudoso; Luna, nunca. El nombre se congeló y llegó al artefacto tal como se transcribió: todos los planes y módulos finales que lo usaban usaban la versión equivocada.
Los errores de puntuación que cambian el sentido, en cambio, se repararon en torno a dos tercios de las veces en los traspasos (Claude 66 %, Luna 73 %), probablemente porque el resto del encargo deja clara la lectura buena. Claude repitió la lectura errónea tal cual en uno de cada siete mensajes, más o menos; Luna, en uno de cada veinte.
El formato importa, según el modelo
Para Claude, el formato del traspaso apenas cambia nada: una lista numerada conserva algo más en el salto 4 que la prosa (88 % frente a 85 % de los hechos), y el código final puntúa más o menos igual en los tres formatos.
Para Luna lo cambia todo.
Cuando vi por primera vez las cifras de Luna di por hecho que su código era peor sin más. No lo es. El cliente enumera los campos de los datos de entrada («cada cita tiene id, customer_name, email…»), y Luna, al resumir en prosa, quitó esa lista del mensaje al implementador en 54 de 72 corridas. El implementador se inventó entonces los nombres (appointment["appointment_id"] en lugar de appointment["id"]) y el módulo reventaba en el primer test. Con una lista numerada el contrato llegó el 89 % de las veces; con el original adjunto, siempre. Su código puntuó entonces 0,76 y 0,86, junto a Sonnet.
Claude conservó ese contrato prácticamente en todas las corridas, en los tres formatos. Sus fallos venían de otro sitio: en 29 de sus 216 corridas de software, el implementador de Haiku no entregó código, sino una especificación, porque esa era la forma del mensaje que le había enviado el arquitecto. El tipo de entregable también se había desviado por la cadena.
Con qué me quedo
- Si el motivo le importa a quien ejecuta, tiene que estar en su mensaje, y nadie lo va a poner por ti. Los roles intermedios lo llevan; el que escribe al ejecutor lo quita. Si quieres que el implementador sepa por qué, dilo en la delegación o adjunta el original.
- Adjunta el encargo original al último salto. Fue el formato más robusto en los tres modelos y el único en el que Luna no perdió el contrato de datos. Cuesta tokens, pero la alternativa es que el implementador adivine nombres de campos.
- Los contratos viajan literales, no resumidos. Nombres de campos, firmas y formas de salida son justo lo que un resumen en prosa elimina porque parece detalle.
- Pide a tus agentes que señalen los nombres que no pueden verificar. Un nombre destrozado no se arregla aguas abajo, pero sí se puede cuestionar, y en estas corridas nadie lo hizo.
Encaja con lo que encontré al comparar formas de hacer colaborar a agentes de código: lo que ayudaba era la forma del equipo y de sus traspasos, no un protocolo de conversación mejor. Aquí también, el efecto más grande no estaba en la inteligencia de los modelos, sino en lo que se le pide llevar a cada mensaje.
Límites
- Seis encargos escritos a mano, tres por dominio. Los errores de transcripción son sintéticos: escritos para parecerse a lo que hace un transcriptor, no producidos ejecutando uno.
- Claude corrió en Claude Code con subagentes de verdad; Luna, en un harness propio. Las comparaciones entre ellos mezclan modelo y harness.
- El juez se validó en una muestra piloto de 150 etiquetas contra un segundo modelo como anotador (Claude Opus 5.5) y un tercero como árbitro (Claude Fable 5.1), no contra etiquetas humanas. Los dos son de la misma familia que los agentes de Claude. En el piloto, su acuerdo fue bueno en las pérdidas y más flojo en las distorsiones (κ 0,79 en conjunto), así que las tasas de distorsión probablemente están infraestimadas. Su acuerdo consigo mismo en una segunda pasada fue de 0,93 (GPT) y 0,97 (Claude).
- Dos comprobaciones de los planes de eventos se corrigieron después de ver los datos: contaban «no Coachline» como una reserva de Coachline. Con la corrección, solo 3 planes en las dos rejillas reservan al proveedor que el cliente había excluido.
- Sonnet delegó dos veces en el mismo paso en el 7 % de sus primeros intentos, sobre todo en corridas de eventos (25 de 30). Esas corridas se repitieron; excluirlas no mueve ninguna cifra más de unos dos puntos.
- El análisis de si el motivo ayuda a cumplir la regla no estaba planeado de antemano.
- Claude Code añade el nombre y el email de la cuenta al contexto de la sesión principal aunque se sustituya el system prompt. En 17 de las 853 corridas de Claude el lead los usó: trató mi email como el del cliente o me nombró como intermediario. Ningún hecho puntuado depende de ello; en los datos publicados están sustituidos.
El código, los seis encargos, todos los mensajes entre agentes, los artefactos finales y las puntuaciones están en experiments/agent-telephone. El diseño, con las hipótesis fijadas antes de las corridas y cada cambio posterior fechado, está en DESIGN.md; scripts/article_numbers.py recalcula desde los datos publicados todas las cifras de este artículo.