Enseñar a un modelo pequeño a reconocer un deporte por puntos en movimiento
En este artículo
En ¿Qué deporte es? convertí a los jugadores en puntos y me pregunté si el deporte se seguía reconociendo por cómo se mueven. La respuesta tenía dos mitades. Un clasificador pequeño entrenado con los puntos acertaba el 83 % de las veces. Cinco modelos de frontera, con los mismos clips, se quedaban entre el azar y el 47 %, y solo uno, Claude Opus 5.5, mostraba que usaba el orden de las fotos.
Quedaba un hueco evidente en medio. Los especialistas que funcionaban se habían entrenado con los datos; los modelos de lenguaje que fallaban, no. ¿Qué pasa si coges un modelo de lenguaje, uno pequeño, y lo entrenas con exactamente lo mismo que vieron los especialistas?
El modelo: Laya
Laya es un modelo de decisión de pesos abiertos de Convai Innovations, con licencia Apache 2.0. Como Jev, no escribe una respuesta: le das un estado, una pregunta y una lista de opciones, y devuelve una probabilidad para cada opción. Usé el checkpoint multilingüe, 322 millones de parámetros sobre un codificador mmBERT, porque su contexto de 1.024 tokens cabe en todos los clips sin recortar nada.
La entrada es la que recibió Jev en el experimento anterior: las coordenadas de los 10 puntos en 8 fotos, escritas como texto. La pregunta también es la misma, con cuatro opciones: fútbol americano, baloncesto, balonmano o fútbol. Sin tocarlo, Laya acierta el 24 % de los clips, que es el azar.
Para que la comparación fuera justa, lo entrené como se entrenaron los especialistas:
- Los mismos folds. Cinco particiones agrupadas por partido, para que ningún partido esté a la vez en entrenamiento y en test, construidas con la misma semilla que MiniRocket y DeepSets. Cada clip lo predice un modelo que no lo ha visto.
- Los mismos 400 clips que respondieron los modelos de frontera, así que cada número de aquí se puede poner al lado de los suyos.
- Las mismas condiciones: las fotos en orden, las mismas fotos barajadas y una sola foto.
El entrenamiento corrió en las GPU gratuitas de Kaggle (dos T4), así que no costó nada, y antes de la primera corrida escribí un pre-registro con las hipótesis, los cuatro contrastes y la corrección por comparaciones múltiples, como en el experimento principal.
La receta oficial no aprendió nada
Laya trae un notebook de ajuste fino para exactamente este hardware. Lo usé tal cual: 4 épocas, sus tasas de aprendizaje, su pérdida. El resultado fue un 23 % en los 400 clips. Al mirar dentro, el modelo había acabado dando la misma puntuación a las cuatro opciones en todos los clips, hicieran lo que hicieran los puntos.
Ese número, solo, no dice nada de Laya. Un modelo puede acabar en el azar porque no hay nada que aprender, porque el código está roto o porque no se ha entrenado lo suficiente, y desde fuera las tres cosas se ven igual. Para separarlas hice un control positivo: los mismos clips, pero con una etiqueta arbitraria al principio de cada uno que codifica la respuesta (tag: Q7 para fútbol, tag: M2 para baloncesto, etcétera). La etiqueta no significa nada, así que el modelo sin entrenar no puede usarla; uno que aprende durante el entrenamiento, sí.
Con la receta oficial, el control llegó al 72 %. El código entrena, pero ni una pista perfecta se aprende del todo con ese presupuesto. El notebook afina con unos 6.000 ejemplos, que dan unas 375 actualizaciones de pesos; aquí hay unos 1.100 por fold, y 72 actualizaciones en total.
El arreglo había que elegirlo sin mirar el resultado que quería medir, así que también usé el control para eso: el número de épocas pasó a ser el primer punto en que el control está aprendido (≥ 95 % en una porción del entrenamiento apartada para ello). Salieron 8. Con 8 épocas, el movimiento siguió en el azar.
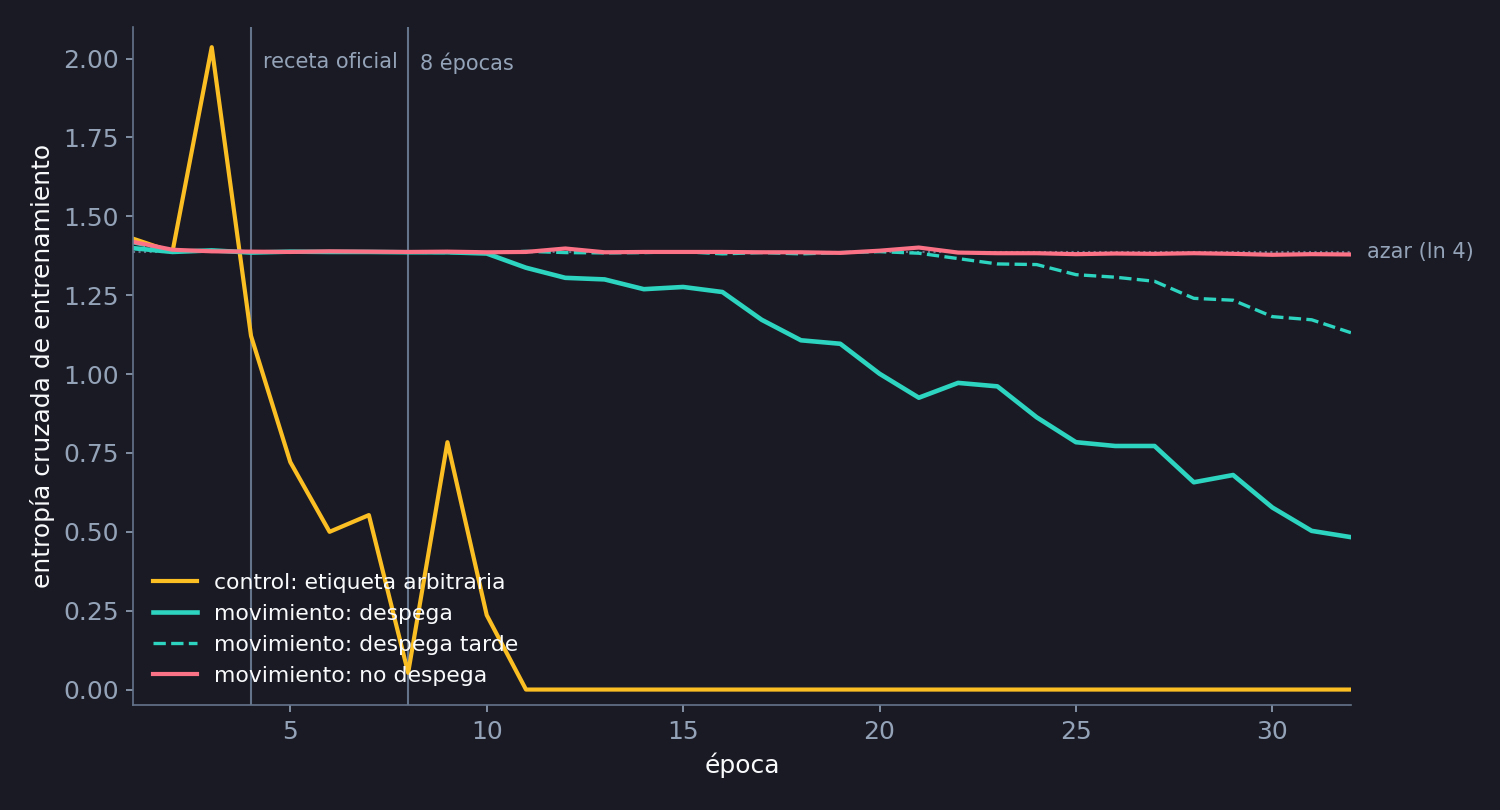
La pérdida de entrenamiento explica por qué. Con los puntos no es que no generalizara: se quedaba en el valor de adivinar entre cuatro opciones incluso en los clips con los que entrenaba. La pista del control es fácil de encontrar; el movimiento no, y tarda más en arrancar.
Con entrenamiento suficiente, lee el orden
Así que lo dejé entrenar hasta 32 épocas y, en cada partición, me quedé con la época que mejor lo hacía en esa porción apartada del entrenamiento, nunca en los clips de test. Es una parada temprana normal, escrita en el pre-registro antes de correrla. La herramienta oficial de entrenamiento de Laya todavía no la incluye, así que abrí un issue que propone esa parada temprana sobre la misma porción apartada y un aviso cuando el entrenamiento se queda en el azar.
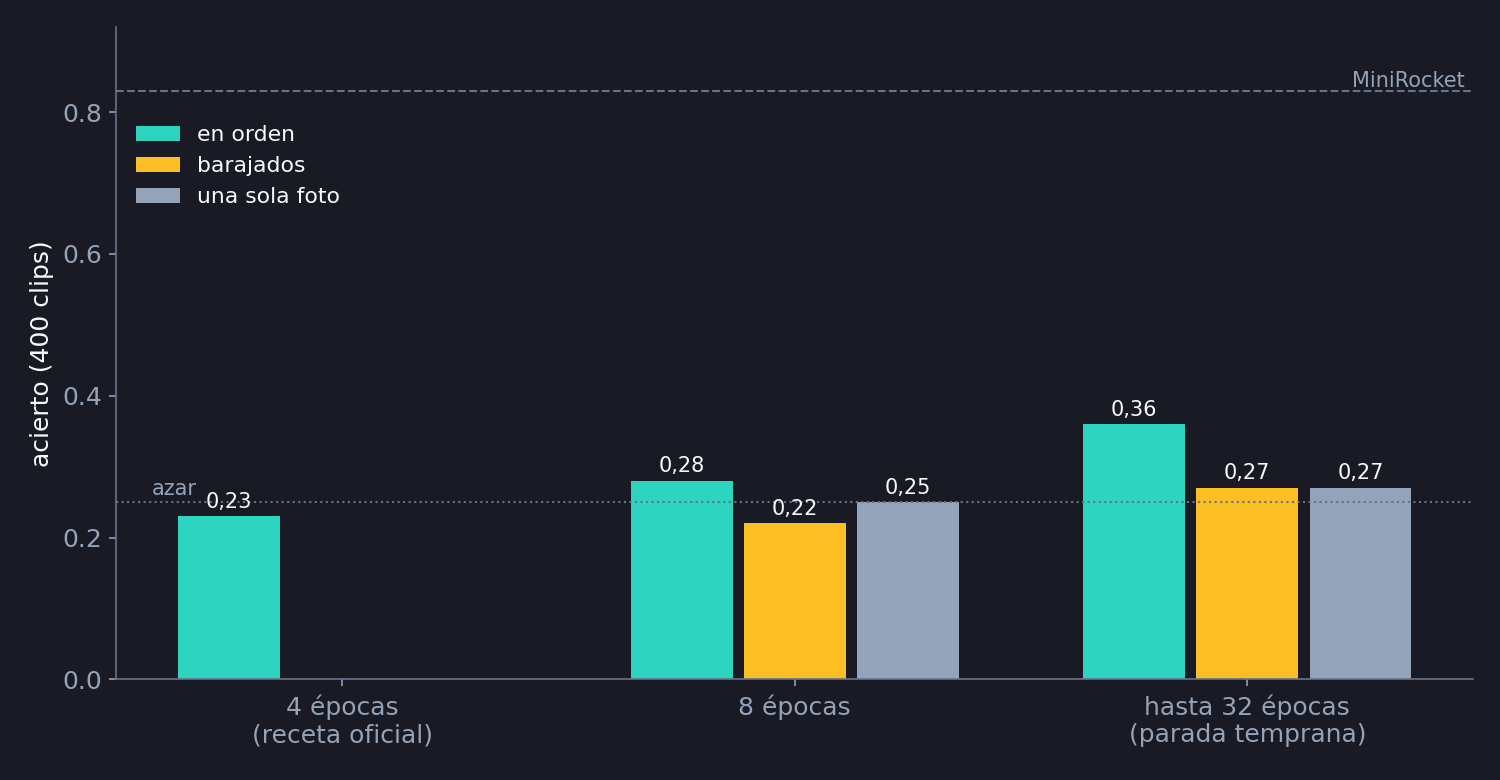
Con tres semillas, los cuatro contrastes pre-registrados:
| Contraste | Diferencia | Intervalo 95 % | p corregido |
|---|---|---|---|
| Afinado frente a sin entrenar, fotos en orden | +0,12 | [0,04; 0,20] | 0,005 |
| En orden frente a barajadas | +0,08 | [0,03; 0,14] | 0,007 |
| En orden frente a una sola foto | +0,08 | [0,02; 0,14] | 0,007 |
| Laya frente a MiniRocket | −0,48 | [−0,54; −0,42] | 0,0008 |
La segunda fila es la que buscaba. Barajar las fotos le cuesta a Laya 8 puntos, del mismo orden que los 10 que le costaba a Opus 5.5, el único modelo de frontera que mostró que leía el orden. Un modelo de 322M entrenado con unos 1.100 clips saca de las coordenadas escritas como texto algo que depende del tiempo, no solo de dónde están los jugadores.
Cómo queda frente a los demás
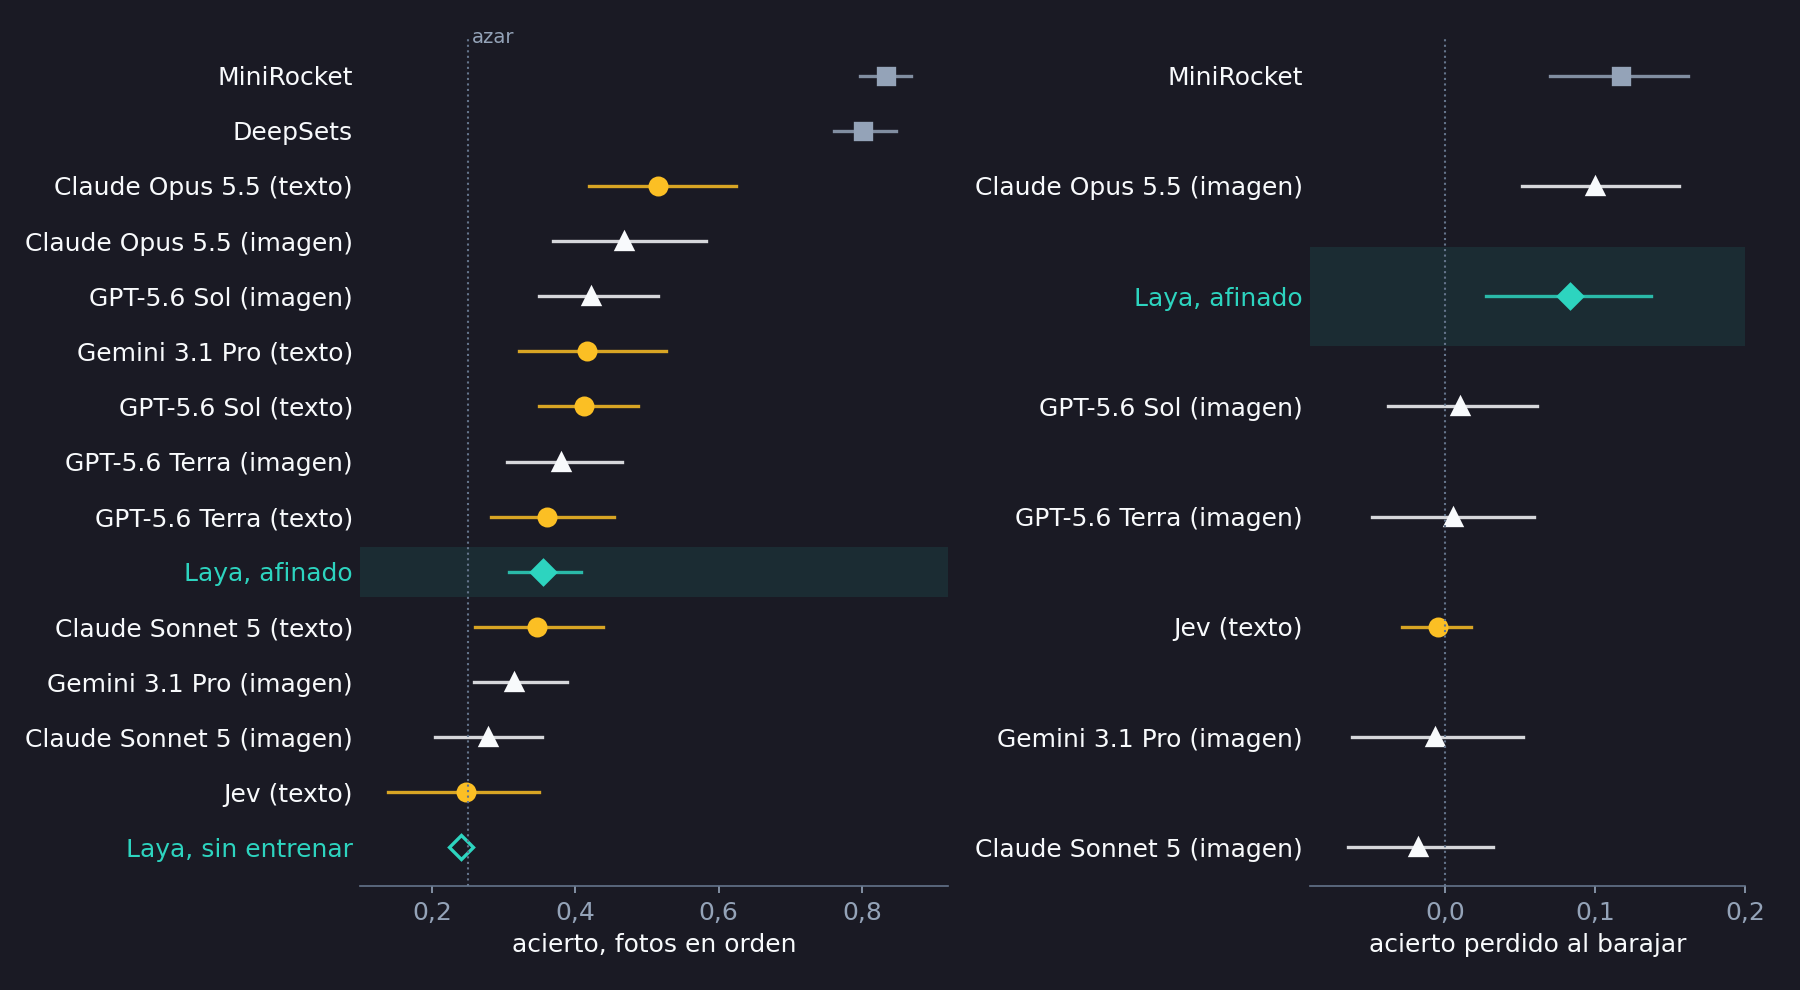
Mismos 400 clips, fotos en orden, todos los modelos del artículo anterior al lado de Laya:
- Frente a los especialistas, Laya queda 48 puntos por debajo de MiniRocket (0,83) y 45 por debajo de DeepSets (0,80), que trabajan directamente con las coordenadas.
- Frente a los modelos de frontera que leyeron el mismo texto, queda a la altura de GPT-5.6 Sol (0,41), GPT-5.6 Terra (0,36), Claude Sonnet 5 (0,35) y Gemini 3.1 Pro (0,42): ninguna diferencia es significativa. Claude Opus 5.5 lee mejor el texto (0,52, 16 puntos por encima de Laya).
- Frente a Jev, el otro modelo de decisión, que recibió el mismo texto sin entrenar, está 11 puntos por encima (0,25 frente a 0,36), una diferencia que con estos 400 clips no llega a ser significativa.
El panel de la derecha es donde cambia de compañía. En acierto, Laya es uno más de los modelos de frontera. En lo que hace con el orden, queda con MiniRocket y Opus, los tres únicos que pierden acierto al barajar las fotos; los otros cuatro modelos de frontera y Jev se quedan en torno a cero.
Por deportes, Laya reconoce el fútbol americano y el baloncesto la mitad de las veces, el balonmano una de cada tres y el fútbol casi nunca, los mismos deportes que se les atragantaban a los modelos de frontera.
Mismos datos, misma receta, otra semilla
Hay una parte del resultado que las medias esconden.
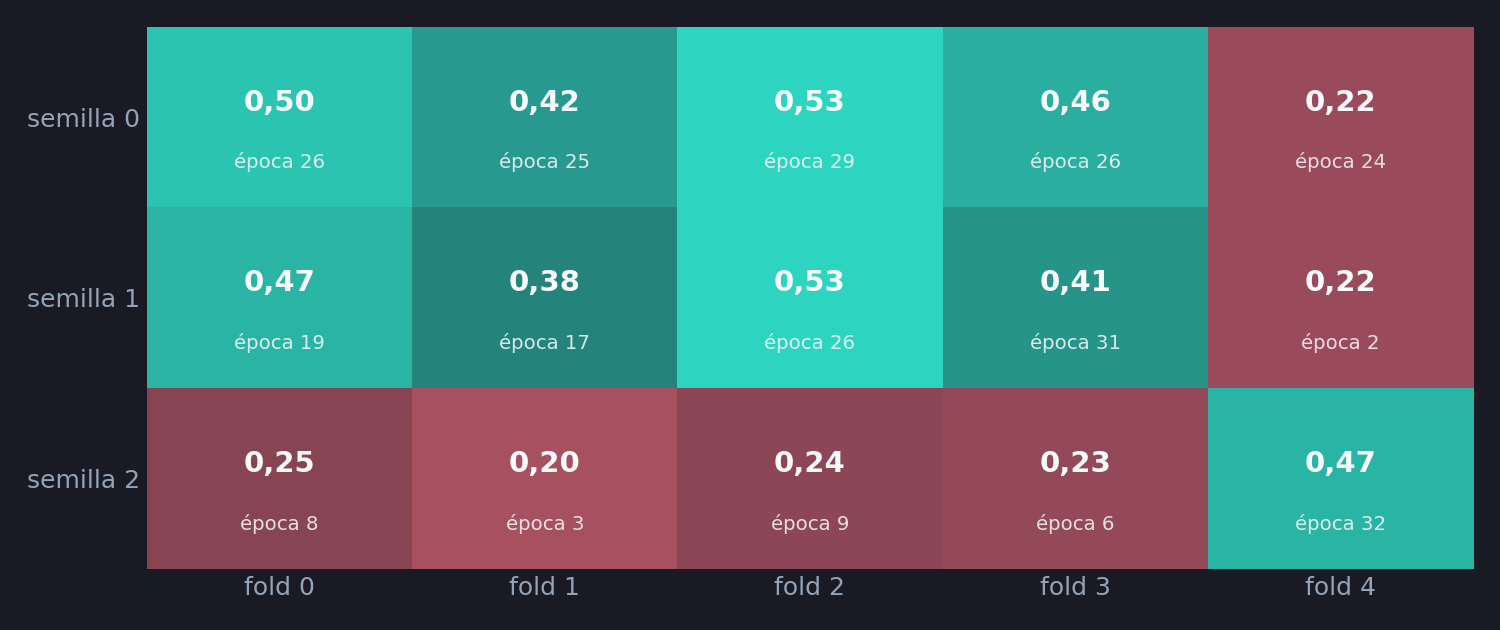
Las quince corridas con las fotos en orden comparten la partición de datos, la receta y el número de épocas; solo cambia la semilla aleatoria. En 9 la pérdida de entrenamiento baja claramente del valor del azar en algún momento; en las otras 6 no sale de él en 32 épocas. Con las semillas 0 y 1 solas, Laya llegaba a 0,40 y el efecto del orden era +0,12. La semilla 2 baja la media a los números de arriba.
Los contrastes aguantan con las tres semillas, y el signo es el mismo en cada una. Pero si hubiera entrenado un solo modelo, la conclusión habría dependido de qué semilla me hubiera tocado: cualquier cosa entre «Laya aprende a leer el movimiento» y «Laya no aprende esto».
Con qué me quedo
Un modelo abierto pequeño puede aprender a leer el orden de las fotos a partir de coordenadas escritas como texto. Lo hace más o menos tanto como el único modelo de frontera que lo hacía sin entrenamiento alguno, y se queda lejos de un especialista que trabaja directamente con los números.
Las dos cosas que casi esconden ese resultado me parecen más generales que el resultado en sí:
- La receta de la ficha de un modelo está ajustada a su propio tamaño de datos. Con cinco veces menos ejemplos, el notebook oficial da un modelo en el azar. Un control positivo barato (una pista trivial que el modelo solo puede aprender entrenando) distingue «este modelo no aprende esto» de «no se ha entrenado lo suficiente», que si no se ven igual.
- Un ajuste fino es una muestra, no una medida. Aquí la misma configuración aprende o no según la semilla. Con tres semillas bastó para verlo; con una habría quedado oculto, en cualquiera de los dos sentidos.
Código, pre-registro y resultados en github.com/JaviMaligno/sport-from-motion. Los resultados de este brazo incluyen las configuraciones que no funcionaron y cada desviación del pre-registro, escrita antes de correrla. Los datos de tracking no se redistribuyen; cada fuente tiene su licencia.