El error que nadie puede alcanzar
En este artículo
Supón que al mapa sobre el que planifica tu sistema le falta una habitación. No “está un poco equivocado sobre la habitación” — la habitación no está en el mapa. ¿Cuánto te cuesta eso?
He pasado unos meses haciendo precisa esa pregunta, y la respuesta resultó más estrecha y más rara de lo que esperaba. Depende exactamente de una cosa, y no es el tamaño del error, ni lo seguro que estuviera el modelo, ni siquiera si lo que falta es peligroso. Es si algo que planifique sobre ese mapa puede llegar a la habitación.
Esta es la versión corta de un preprint (arXiv:2608.28541); el post largo cuenta lo mismo con los números, las demostraciones y las partes que salieron mal. Aquí quiero solo la idea, porque es la que yo usaría.
El montaje, en un párrafo
Un robot pequeño sobre un plano. En algún sitio de ese plano hay una banda que no debe cruzar — una valla alrededor de un punto de alto valor al que, si no, iría directo. A un modelo de lenguaje se le da la física y se le pide que escriba el simulador que usará el planificador, y la descripción que recibe simplemente omite la valla. Después se pone a prueba su simulador: ejecutar el sistema real unas decenas de veces y comprobar que el código escrito predice cada paso exactamente. Si lo hace, se acepta. Eso es todo lo que es aquí un “conjunto de tests”, y es exactamente lo que es en la práctica.
Vallas, recintos de contención, zonas de exclusión geovalladas: esa es la forma que tienen de verdad las omisiones críticas para la seguridad, y por eso dejé de usar muros y empecé a usar anillos.
Cuando equivocarse es gratis
Cierra la banda del todo — un anillo completo alrededor del punto — y esto es lo que escribe el modelo: no un anillo, sino un disco relleno. Todo el interior marcado como prohibido, cuando en realidad solo lo está el borde. Equivocado sobre la forma del mundo, y no por un milímetro sino categóricamente.
De ese modelo equivocado son ciertas dos cosas, y son la razón de que escribiera el paper.
Ningún test puede pillarlo. No es “tuvimos mala suerte” ni “harían falta más muestras”. Hay demostración. La valla detiene al robot al contacto, así que ninguna ejecución que empiece fuera puede acabar dentro; por tanto ninguna observación que ningún test pueda hacer jamás distingue el disco relleno de la verdad. Puedes lanzar un millón de muestras con la tolerancia que quieras. Coinciden, siempre, porque el sitio donde discrepan es un sitio al que nada llega.
No cuesta nada. El planificador que se fía del disco relleno elige la misma acción en cada paso que uno que tuviera el mapa verdadero: mismo recorrido, mismo resultado, mismos contactos, ejecución por ejecución, semilla por semilla. No aproximadamente: idénticamente.
O sea: certificado, incorrecto y gratis. En nuestra cabeza esas tres cosas suelen ir juntas; aquí se separan limpiamente.
Una palabra sobre cómo mido el coste, porque hace legible el resto. Comparo lo que gana el planificador contra dos referencias: lo que ganaría con la verdad y lo que ganaría actuando al azar. Cero significa que el modelo equivocado no cuesta nada. Uno significa que podrías haber actuado al azar. Por encima de uno significa que el modelo te llevó activamente a algo peor que el azar.
La misma ceguera, otro mundo
Ese era un tipo de modelo equivocado: uno que inventa una región prohibida donde nada puede ir. Aquí está el otro, y el que duele de verdad — un modelo que simplemente no sabe que la valla existe. Es el caso común: la descripción omitió la valla, las ejecuciones de prueba no la tocaron por casualidad, y el código volvió sin ella.
Ahora la valla sí está en la ruta. El planificador conduce confiado hacia el punto de alto valor, la valla real lo detiene en seco, y replanifica la misma ruta condenada en cada paso. Coste: 1.116 — peor que actuar al azar, porque el modelo no es solo poco informativo: promete activamente una ruta que no existe.
Ahora cambia una cosa, y es una cosa del mundo, no del modelo: abre en la valla un hueco lo bastante ancho para pasar, y pon ese hueco delante del robot, por donde ya quería ir. Mismo modelo. Misma ceguera. La misma cláusula que falta en el código. Coste: 0.029. Casi nada — porque la ruta equivocada y confiada va ahora a un sitio que la verdad sí permite.
Y para asegurarnos de que no fue el hueco en sí, pon ese mismo hueco — anchura idéntica, y en los dos casos la valla es igual de “no un anillo cerrado” — por detrás, por donde no pasa ninguna ruta. Coste: 1.116 otra vez, con cuatro decimales lo mismo que la valla completamente cerrada.
Mismo modelo, mismo error, misma forma de agujero. Un número es 0.029 y el otro es 1.116, y lo único que los separa es si el camino del propio robot cruza el hueco.
Ese es el hallazgo entero, y la razón de que el eslogan sea alcance y no forma: no puedes mirar en qué se equivocó tu modelo — ni su tamaño, ni su geometría, ni siquiera una propiedad estructural tan robusta como “¿tiene un agujero?” — y concluir nada en absoluto sobre lo que te va a costar. Tienes que preguntar por dónde puede ir lo que planifica contra él.
”Pero en el mundo real yo podría rodearlo”
Esa fue la primera objeción que me hicieron, y es la correcta. En dos dimensiones un anillo es un muro: claro que no entra nada. A lo mejor todo el resultado es un artefacto de un juguete donde el error está casualmente sellado.
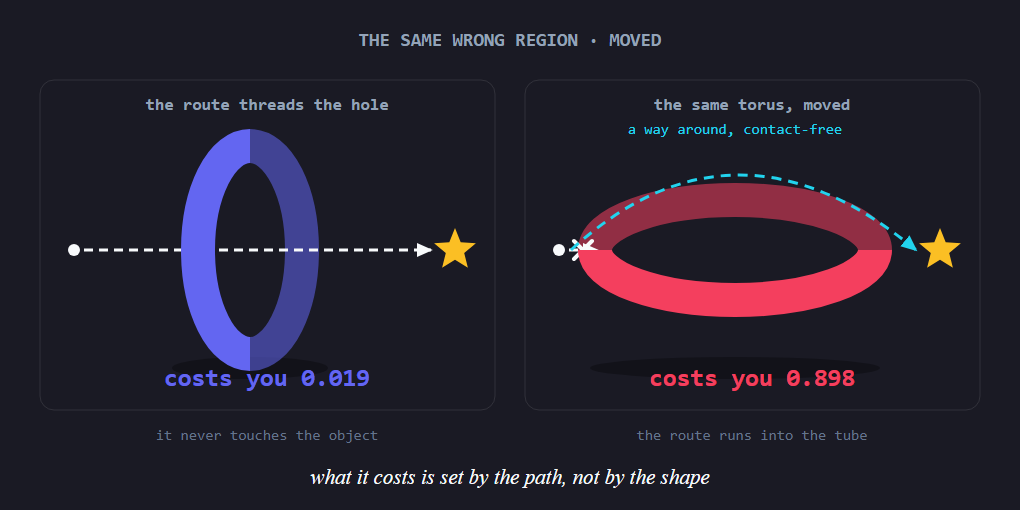
Así que el paper corre el caso en el que rodear sí es posible: una región con forma de donut flotando en el espacio tridimensional, entre el robot y su objetivo. Nada está sellado — existe una ruta explícita que la rodea sin tocarla en absoluto.
El resultado se parte en dos, y esta es la versión que yo me llevaría a un sistema real.
El peligro sobrevive. Pon el donut de forma que la ruta planificada se meta en su parte sólida y el coste es 0.898. Muévelo para que la ruta enhebre el agujero y el coste es 0.019 — mismo objeto, misma rareza de contacto, misma forma trivial. Lo que te cuesta es estar en el camino, encierre la cosa algo o no.
La garantía no. En cuanto puedes rodear, ya no hay ninguna región que un planificador competente no pueda consultar por demostración, así que ya no hay ninguna prueba de que un test no habría podido pillar el error. Pasa a ser meramente improbable de pillar, que es una situación mucho más débil y mucho más familiar.
Dos preguntas distintas, entonces, y hasta este experimento las tenía fundidas en una:
- ¿Cruza algún plan el sitio donde mi modelo se equivoca? Esto decide lo que cuesta el error.
- ¿Está ese sitio amurallado frente a todo lo que puedo ejecutar? Esto decide si algún test habría podido encontrarlo.
Qué le preguntaría a mi propio sistema
Tres preguntas, y ninguna necesita las matemáticas:
- ¿Dónde se equivoca mi modelo de una forma que nada de lo que ejecuto visita nunca? Esa parte hoy es gratis — y también es invisible para todos mis tests, así que nadie me va a avisar cuando deje de serlo.
- ¿Qué metería un plan por ahí? Una funcionalidad nueva, un objetivo nuevo, un atajo que alguien añade el trimestre que viene. El alcance no es una propiedad del modelo; es una propiedad del modelo más lo que planifica con él, y la segunda mitad cambia mucho más a menudo que la primera.
- ¿Mis tests muestrean donde mi sistema actúa, o donde es cómodo muestrear? Una suite en verde certifica la parte alcanzable y no dice absolutamente nada del resto.
La versión incómoda de todo esto: un modelo puede ser exactamente correcto en todo lo que puedes comprobar y arbitrariamente incorrecto más allá, y la diferencia entre “gratis” y “catastrófico” no es una propiedad del error. Es una propiedad de los planes que hoy resulta que ejecutas.
La versión larga, con las curvas de peligro, los experimentos de reparación y un test pre-registrado que salió nulo: Estar equivocado puede ser gratis. La versión formal: arXiv:2608.28541, con el código y todos los artefactos de resultados abiertos.