La regla estaba en la otra rama
En este artículo
Todos los equipos con los que he trabajado guardan sus prácticas en una docena de sitios. El checklist de las PR vive en un repositorio. Quién promueve a producción está en una página de la wiki de toda la organización. La rama en la que integra un proyecto es una convención de ese proyecto. El comando de tests está en un README, salvo que se haya movido a un Makefile. Y buena parte solo vive en la cabeza de quienes llevan más tiempo.
Las personas lo absorben en meses. Un agente empieza cada sesión sin nada de eso, o con una copia que alguien pegó en un prompt y que se quedó vieja a la semana siguiente.
Por eso hice delivery-loop, un plugin para Claude Code y Codex que lleva una tarea desde su ticket hasta un cambio verificado en un entorno de pruebas y traspasado. Llevar una tarea hasta el final no es nuevo por sí solo. Lo que hace que funcione en más de un sitio es de dónde saca el agente las prácticas del sitio donde trabaja, cómo se comparten entre quienes lo usan y cómo se mantienen al día sin que nadie tenga que mantenerlas.
El bucle, fase a fase
Primero, qué hace el bucle. Una tarea pasa por diez fases; una pequeña se salta la especificación, las preguntas abiertas y el plan.
- Entender. Comprueba si el trabajo ya está hecho (un ticket marcado como pendiente puede estar en producción por una PR que nunca lo citó), crea un espacio de trabajo aislado y dimensiona la tarea. Convierte el ticket o el documento en puntos con IDs estables, separa lo que solo puede decidir una persona y escribe un plan que otro agente revisa antes de tocar código.
- Construir. Primero los tests, luego el cambio, en commits ligados a los IDs; después una revisión independiente con los revisores que diga el perfil.
- Demostrar. Tras el merge, espera a que el entorno de pruebas sirva ese commit exacto, no a que el despliegue diga que ha ido bien. Luego comprueba cada ID contra el entorno desplegado. Siempre que haya algo que ver, la evidencia es visual: capturas o una grabación, que se suben al ticket. Una API o una cola llevan en su lugar una respuesta real.
- Traspasar. La promoción a producción o, cuando es cosa de otro, un traspaso explícito con el material preparado. Después el ticket pasa a hecho con su evidencia, y se limpian ramas, espacios de trabajo y datos de prueba.
Casi cada uno de esos pasos se apoya en una práctica del sitio: qué estado del ticket significa «en revisión», quién revisa, en qué rama se integra, cómo llega un cambio al entorno de pruebas, quién promueve. Para eso están los perfiles.
Cada práctica se escribe una vez, en su nivel
El núcleo del plugin no nombra ninguna herramienta. Todo lo propio de un sitio va en un perfil, y los perfiles van por niveles que reflejan dónde viven ya las prácticas. «La promoción a producción es del equipo de plataforma» es verdad para toda la organización, así que va en el perfil de la organización. «Este repo integra en develop» es verdad para un repositorio, así que va ahí. Nada se copia en cada repo y nada está en el plugin.
Pensado para compartirse
Esto es lo que hace que merezca la pena montarlo. Una organización guarda sus perfiles en un repositorio privado: el nivel de organización y un perfil por proyecto. Una persona nueva instala el plugin, ejecuta un script y recibe el perfil de la organización más los de los proyectos cuyos repos tiene de verdad. Nada más.
Alguien tiene que escribir antes esa parte compartida, pero no a mano. La primera ejecución en una organización detecta lo que puede y hace una ronda corta de preguntas sobre el resto, y cada respuesta se escribe en su nivel, incluidos el de organización y el de proyecto. Publicar esos ficheros en el repo compartido es lo que ahorra esa misma ronda a todos los que vienen después. A partir de ahí se va completando mientras la gente trabaja: una regla que alguien añade, un proyecto que alguien empieza.
Lo que le queda es poco, y casi todo se escribe una vez:
- Su perfil de usuario. Sus cuentas, los límites de su máquina, la herramienta de navegador que usa. Se escribe una vez, se queda para siempre y nunca forma parte de un fichero compartido: el CI del repo compartido comprueba que ningún perfil compartido tenga datos personales.
- Cada repo nuevo. La primera ejecución en un repo sin perfil detecta lo que puede (remote, protección de ramas, jobs de CI, runners de tests, configuración de despliegue) y pregunta solo lo que la detección no resuelve, una vez y con una respuesta recomendada. El resultado se versiona en el repo, así que el siguiente compañero que haga pull lo tiene sin ejecutar nada. En el repositorio de un cliente, ese mismo perfil se queda en local, dentro de
.git, para que nunca llegue al cliente.
Nadie vuelve a aprender la organización. Cuando una regla cambia para todos, cambia en un sitio con una PR y todos la reciben en la siguiente instalación. Cuando un repo cambia su rama de integración, el perfil de ese repo cambia con él.
El mismo plugin, dos organizaciones
Lo uso en dos organizaciones que trabajan de forma muy distinta. En una, la rama de integración es develop, un cambio llega al entorno de pruebas subiendo una versión en un repositorio de configuración aparte, y la promoción más allá es de otro equipo. En la otra, varios proyectos de cliente tienen cada uno sus entornos y su proceso de release, las revisiones incluyen agentes de revisión propios de la empresa, y los repositorios de cliente nunca deben recibir nuestros ficheros.
El núcleo es el mismo en las dos, sin cambios, en Claude Code y en Codex. Cada una de esas diferencias es una línea en un perfil, en su nivel. El repo público solo lleva perfiles de ejemplo ficticios; los reales viven en el repo privado de cada organización.
Mantenerlas al día
Un perfil que era correcto al escribirlo se queda viejo solo, igual que las memorias que guarda mi agente: nunca fueron falsas al escribirse, describían un estado que caducó. Por eso el perfil se trata como algo que hay que volver a comprobar, no como algo de lo que fiarse:
- Al empezar cada tarea, una comprobación barata compara el perfil con lo que muestra el repo. Si algo no cuadra, se actualiza ese dato en su nivel y se deja una línea en el informe.
- Cualquier dato con más de 30 días se vuelve a verificar antes de que el bucle se apoye en él.
- Cuando el perfil y otra fuente no coinciden, gana la fuente fechada más reciente, y la vieja se corrige donde vive, así que el arreglo llega a todos los que comparten ese nivel.
- Los perfiles se vuelven a combinar a mitad de tarea, porque las reglas pueden cambiar mientras el trabajo está en curso.
La regla estaba en la otra rama
Mantener las prácticas al día es solo la mitad. El agente además tiene que leer las vigentes, y ahí una ejecución real me sorprendió.
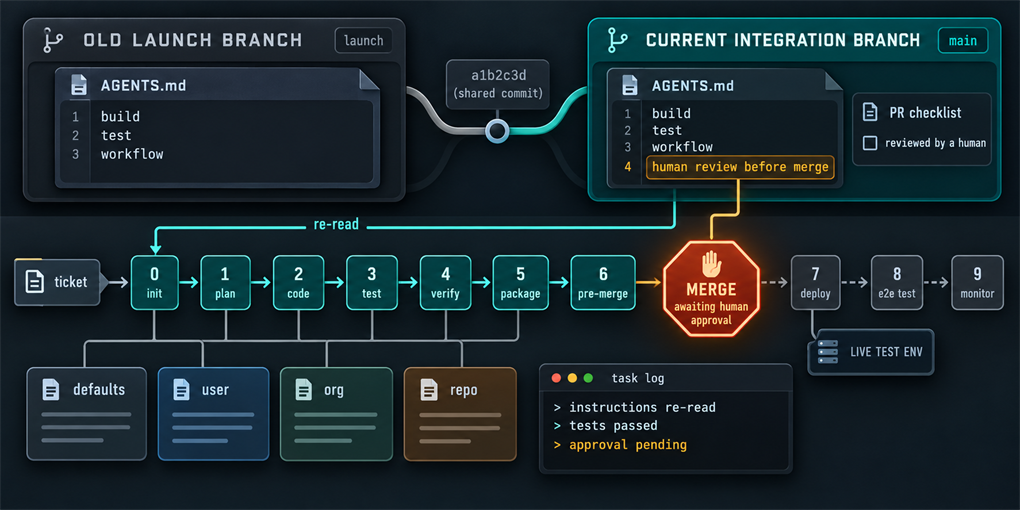
Un repositorio en el que trabajo había añadido una regla a su checklist de PR: una persona tiene que dar fe de que ha revisado cualquier código generado por IA antes de que salga. Una ejecución se paró antes del merge y me pidió esa revisión. Dos ejecuciones anteriores en el mismo repositorio habían mergeado sin ella. La regla estaba vigente y en el sitio correcto, la rama de integración. Pero las tres sesiones se habían lanzado desde un checkout en una rama más antigua, cuyos ficheros de instrucciones son anteriores a la regla. Después el trabajo se hacía en un worktree nuevo sobre la rama de integración. La ejecución que se paró releyó allí las instrucciones; las otras trabajaron con la copia con la que habían empezado.
Así que ya no se deja al azar: cuando una sesión se lanzó desde una rama distinta de la de integración o la de producción, el plugin lee los ficheros de instrucciones del repositorio desde el espacio de trabajo donde se hace el trabajo y deja constancia de qué rama vienen.
Menos preguntas por el camino
Unos perfiles compartidos y al día son también lo que permite que el bucle avance sin pararse a preguntar. Antes de empezar, prueba con una llamada real cada capacidad que va a usar la tarea, porque configurado no es autenticado y autenticado no es que funcione: una herramienta que aparece como conectada puede fallar en su primera llamada, y gh auth status puede decir una cuenta mientras los comandos corren con otra. Lo que falla se plantea en una sola ronda, y la respuesta se guarda en su nivel para que nadie vuelva a preguntar. Lo que queda para una persona son las decisiones que de verdad son suyas: una decisión de negocio, un texto que verá el cliente, la revisión de la que esa regla tiene que dar fe.
Por dónde empezar
Las fases son la parte visible. Lo que hace que funcionen en cualquier sitio es la idea de debajo: cada práctica escrita una vez, en el nivel donde es verdad, compartida con todos los que la necesitan, recomprobada antes de que nadie se apoye en ella y leída desde la rama donde de verdad se trabaja. Nadie tiene que mantener al día al agente, porque las prácticas que lee son las mismas que el equipo ya mantiene.
Si tu equipo quiere probarlo, basta con que una persona lo use en un ticket real y publique los perfiles de organización y de proyecto que escribe. El repositorio trae un ejemplo ficticio de cada nivel con el que compararlos.
delivery-loop en GitHub (MIT). Se instala en Claude Code con claude plugin marketplace add JaviMaligno/delivery-loop, o en Codex con codex plugin marketplace add JaviMaligno/delivery-loop. Más de lo que empaqueto para agentes en Plugins y Skills.