Lo que la IA te obliga a aprender
En este artículo
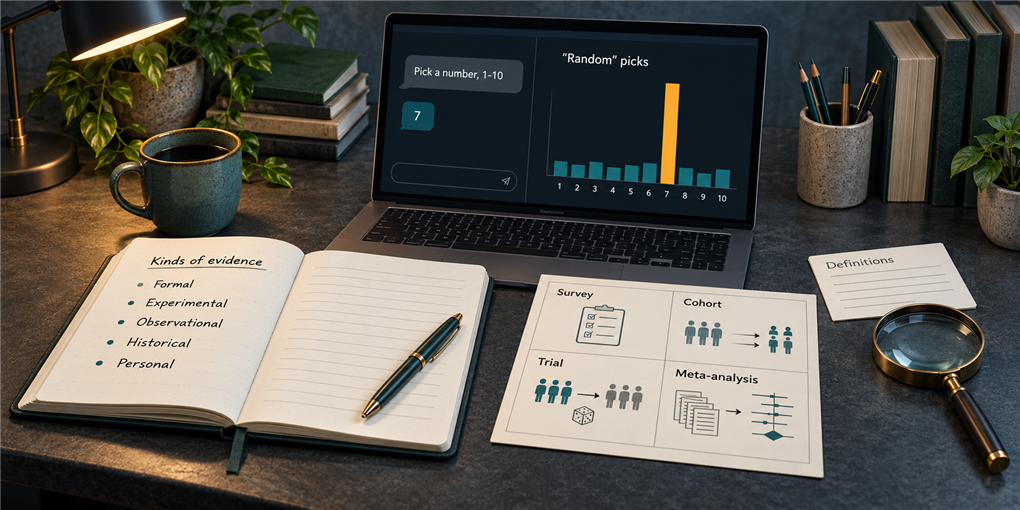
Pídele a un modelo de lenguaje que elija un número al azar entre 1 y 10. Lo he hecho 900 veces, con nueve modelos de Claude y de GPT, y las 900 veces la respuesta fue 7. Pídeselo entre 1 y 100 y cada modelo tendrá su favorito: en unas pruebas con varios modelos, ChatGPT se quedaba con el 47, Claude 3 Haiku con el 42 y Gemini con el 72. Un estudio de 2025 lo atribuye a los sesgos de los datos con los que se entrenaron.
No es un fallo curioso. Es la forma más simple de ver cómo funciona por dentro, y explica casi todo lo que conté en Oráculo o herramienta: por qué la primera respuesta es la convencional, por qué las definiciones derivan hacia el uso popular. Allí defendía que para usar la IA no hace falta saber de todo, sino tener un método. Este artículo trata de lo que hace posible ese método: unas cuantas habilidades, algunas técnicas y la mayoría filosóficas, que la IA vuelve más útiles que nunca.
Por qué tira hacia lo más probable
Un modelo de lenguaje se entrena para predecir la siguiente palabra de un texto (técnicamente, el siguiente token, un trozo de palabra). Se le enseñan cantidades enormes de texto escrito por personas y, mediante un procedimiento llamado descenso de gradiente, se ajustan sus parámetros poco a poco para que se equivoque cada vez menos en esa predicción. El resultado es un modelo que ha aprendido qué suele venir después de qué: la distribución de lo que la gente escribe.
Cuando le preguntas algo, el modelo genera la respuesta eligiendo, palabra a palabra, entre las continuaciones más probables. Y las personas, cuando nos piden un número al azar, también elegimos el 7 mucho más de lo que tocaría: en una encuesta de YouGov a 2.241 adultos británicos, un 33 %, frente al 10 % que daría el azar. El modelo ha aprendido ese sesgo humano y, al quedarse con lo más probable, lo lleva al extremo. Le hice la misma pregunta de la encuesta, cien veces a cada uno, a cinco modelos de Claude y cuatro de GPT, a través de Claude Code y Codex:
Después viene una segunda fase de entrenamiento, en la que el modelo se ajusta según las respuestas que las personas valoran mejor. Eso lo vuelve más útil y más educado, pero reduce la variedad de lo que responde: empuja hacia la respuesta que más gente aprobaría.
Con esto se entienden tres cosas que el usuario nota sin saber por qué:
- La respuesta convencional. Sobre nutrición se ha escrito mucho más la recomendación mayoritaria que cualquier alternativa, así que es lo que sale primero.
- La definición popular. Si una palabra se usa de forma laxa mil veces por cada vez que se usa con rigor, el modelo tiende al uso laxo, aunque se lo hayas precisado hace tres mensajes.
- El tono complaciente. Darte la razón suele valorarse mejor que llevarte la contraria.
Nada de esto lo convierte en inútil. Significa que la respuesta por defecto es la más probable, no la más justificada, y que conseguir la segunda depende de ti.
Cada conocimiento tiene su evidencia
En el artículo anterior distinguía cinco tipos de conocimiento: formal, experimental, observacional, histórico y personal. Lo experimental y lo observacional es lo que normalmente entra en el método científico. Lo histórico suele quedar aparte, aunque algunas convenciones lo incluyen. Lo formal sostiene a todos los demás, porque cualquier razonamiento usa lógica. Y lo personal es intransferible.
Cada uno se apoya en una clase de evidencia distinta, y aquí es donde la IA más tropieza. Dos errores aparecen una y otra vez:
- Exigir una demostración formal para aceptar un hecho histórico. Ningún hecho histórico se demuestra como un teorema. Se establece con restos, documentos, testimonios y la convergencia de varias huellas independientes, y eso puede dar un apoyo muy fuerte.
- Presentar la evidencia empírica como si fuera una necesidad lógica. Que algo se haya observado siempre no lo convierte en imposible de otra manera.
La lógica interviene en los dos casos. Lo que cambia es cómo se justifican las premisas y con qué fuerza se sigue la conclusión.
Lo he visto en mi propio trabajo. Llevo meses construyendo con IA una ontología, una investigación filosófica sobre qué existe y cómo depende una cosa de otra (está en un repositorio público). El modelo repetía una y otra vez «esto no demuestra X» ante conclusiones históricas bien apoyadas. Es verdad que no las demostraba: no son de esa clase. Pero esa frase ocupaba el lugar de lo que había que hacer, que era evaluar cuánto apoyo tenían y si alguna alternativa tenía un apoyo comparable. Una alternativa que solo es concebible no pesa lo mismo que una con evidencia detrás. Lo corregí y quedó escrito como regla en la metodología del proyecto.
Hay un segundo error, distinto, que no tiene que ver con el tipo de evidencia sino con no usar la que ya hay. Al pasar a una pregunta nueva, el modelo trataba un fundamento que ya estaba justificado como si fuera una simple interpretación, y volvía a pedir que se probara desde cero en lugar de apoyarse en lo ya establecido. También eso estaba escrito como regla, y aun así reapareció. Tener las reglas por escrito ayuda mucho, pero no garantiza que se apliquen. Sigue haciendo falta alguien que sepa reconocer el error.
Cada estudio responde a una pregunta
Dentro de lo experimental y lo observacional hay además distintos tipos de estudio, y la IA suele citarlos sin decirte cuál es cuál. Es habitual presentarlos como una escalera, con el ensayo aleatorizado arriba y la encuesta abajo. Es más útil verlos como herramientas para preguntas distintas. Ninguno es «el que dice la verdad»: cada uno da un grado de conocimiento distinto, bajo condiciones distintas.
Un ensayo aleatorizado es la mejor forma de saber si una intervención causa un efecto, pero suele durar semanas o meses, con una dosis concreta y en una población concreta. Un estudio de cohortes puede seguir a decenas de miles de personas durante décadas, pero no controla todo lo que influye en ellas. Para la pregunta «¿qué le pasa a alguien que sigue esta dieta durante veinte años?» no existe ningún ensayo aleatorizado, y probablemente nunca existirá.
Por debajo hay además una parte estadística que conviene conocer, aunque sea de forma intuitiva:
- Todo resultado depende de las hipótesis del modelo estadístico con que se analizó: qué se supuso, qué variables se ajustaron y cuáles no.
- Que un efecto sea estadísticamente significativo no dice que sea grande. Con muestras enormes, efectos minúsculos salen significativos.
- Un riesgo relativo no es un riesgo absoluto. «Duplica el riesgo» puede significar pasar de 1 entre 10.000 a 2 entre 10.000.
Con esto ya puedes pedirle a la IA lo que importa: qué tipo de estudio respalda cada afirmación, qué pregunta responde ese tipo de estudio y qué supuestos hay detrás. Sobre cómo evaluar el conocimiento cuando estos estudios no bastan, o llegan tarde, escribí un libro entero, Science Catch-Up.
Las definiciones derivan
El mismo mecanismo que da el 7 hace que los conceptos converjan hacia lo que más popularmente se entiende por una palabra, no hacia su definición adecuada. En una conversación larga se nota: precisas un término, el modelo lo usa bien un rato y, unos mensajes después, ha vuelto al sentido corriente.
Para manejarlo ayuda distinguir tres cosas que suelen mezclarse:
- Una estipulación: «en este texto, X significa esto». Se decide, no se discute.
- Una descripción del uso: cómo se usa la palabra de hecho. Se comprueba.
- Una propuesta sobre la naturaleza de algo: qué es realmente X. Necesita argumentos.
Basta pensar en palabras corrientes donde, si no lo dices, el modelo elige por ti:
- Materialismo. Hay varios materialismos filosóficos distintos, además del sentido de andar por casa. El modelo tomará uno por defecto, o el popular.
- Cristianismo. Puede ser una doctrina completa y precisa, o todo lo que popularmente se reconoce como cristiano, que es mucho más amplio.
- El método noruego (o nórdico) de HIIT. Con ese nombre circulan al menos dos cosas: el protocolo 4×4 de la universidad de Trondheim (cuatro series de cuatro minutos al 85-95 % de la frecuencia cardiaca máxima, con tres de recuperación) y el entrenamiento de doble umbral de los fondistas noruegos, guiado por el lactato, que ni siquiera es HIIT en sentido estricto.
Si no tienes claro cuál es la definición correcta, la IA puede ayudarte a averiguarlo: qué variantes hay, de dónde viene cada una, cuál usan los especialistas. Pero hay que interrogarla, no quedarse con la primera.
Ninguna definición demuestra por sí sola que exista lo que define. Y el prestigio de un término tampoco sustituye a una definición que sirva para razonar: en la ontología, el modelo propuso usar un concepto clásico, «perfección ontológica», que resultó demasiado amplio para la distinción que yo necesitaba. Tuve que desglosarlo en tres conceptos más precisos.
La herramienta práctica es la misma que en el artículo anterior: escribir las definiciones que importan en un glosario, o en las instrucciones del proyecto, para no tener que repetirlas.
Acertar no es conocer la verdad
Todo lo anterior gira alrededor de lo mismo. Lo más difícil para una inteligencia artificial es lo que tiene que ver con la verdad, y creo que es precisamente lo que la distingue de la nuestra.
Un modelo sigue patrones. Acumula lo que indican los datos y lo devuelve, sin una noción interna de qué es verdad. A medida que se entrena mejor, aprende a distinguir mejor los tipos de conocimiento, porque aprende mejor cómo los distinguimos nosotros. Eso lo hace más útil. Pero producir respuestas correctas no es lo mismo que tener una relación propia con la verdad.
Mi razón para afirmarlo es teísta, y es la conclusión del trabajo de la ontología, no un añadido:
- El ser humano está creado a imagen de Dios, y su condición de sujeto racional la recibe de él.
- Conferir esa condición le corresponde solo a Dios. Tenerla no nos da el poder de conferirla fabricando algo.
- Una IA es un artefacto construido por seres humanos.
- Por tanto, fabricar una IA no le da por sí mismo aquello que solo Dios puede dar.
Por eso nuestra razón está orientada a una verdad objetiva que existe y que intentamos alcanzar, y la de la máquina no. El desarrollo completo, con sus objeciones, está en el repositorio de la ontología.
No hace falta compartir este fundamento para sacar la conclusión práctica. Mientras el modelo no tenga una relación propia con la verdad, alguien tiene que tenerla por él. Ese alguien eres tú.
Por qué la filosofía vuelve a importar
Si juntas todo, la lista de lo que conviene saber para usar bien la IA se parece poco a un curso de programación:
- Cómo se entrena un modelo, lo justo para entender por qué tira hacia lo más probable.
- Epistemología: qué tipos de conocimiento hay y qué evidencia vale para cada uno.
- Método científico y estadística básica: qué pregunta responde cada tipo de estudio y qué supuestos tiene.
- Definiciones: cuándo se estipula, cuándo se describe y cuándo hay que argumentar.
- Una noción de verdad que no se reduzca a lo que dice la mayoría.
Todos somos un poco filósofos por naturaleza, porque nacemos con curiosidad. Pero la comodidad de tener el conocimiento a mano nos hace perder la práctica. Cuanto más capaces son los modelos, más vale lo que no traen de serie: saber juzgar lo que producen. Esa es una habilidad filosófica, y no hace falta ser filósofo para tenerla. Basta con aprenderla lo suficiente para hacerse las preguntas correctas, y enseñarla a quien tengas cerca.