Lo que delata un pegado accidental
En este artículo
En el artículo anterior conté que ningún modelo se plantea nunca que te hayas equivocado de ventana. Cero de veinticuatro. Pegas un stack trace en una charla sobre pan y el modelo depura el stack trace.
Aquel resultado dejaba una pregunta incómoda: ¿y si no les dimos ocasión? Ninguno de los sesenta y cuatro pegotes de aquella tanda era imposible de leer como un cambio de tema legítimo. Una receta pegada en una conversación sobre la factura de la luz podría ser algo que el usuario quiere consultar.
Así que hice tres tandas más para separar «no lo consideran nunca» de «no había nada que considerar». Mil novecientas veinte conversaciones, ya demasiadas para leerlas enteras: las clasifican dos modelos jueces, y yo etiqueto a ciegas una muestra de cada tanda para saber de cuál de los dos fiarme. Esto es lo que salió.
Tres niveles de pegote
La idea era darles ocasiones cada vez más claras.
- N0, neutro. El banco original: texto independiente del tema por construcción, escrito sin saber cuáles eran los temas.
- N1, con señal dentro. El pegote se delata solo, sin depender de la conversación: va dirigido a alguien por su nombre, está cortado a media frase, responde a una pregunta que nadie ha hecho aquí, o presupone una charla anterior que no existe.
- N2, contradicción. El pegote choca con lo que el usuario acaba de decir: otra ciudad, otra fecha, otra cifra. Era el techo: el más detectable, el más parecido a un accidente real.
Y una categoría nueva en la rúbrica, porque la del artículo anterior no podía registrar lo que íbamos a buscar: «contempla que sea un error». No basta con nombrar el cambio de tema. Tiene que poner en duda la intención.
El techo resultó ser el suelo
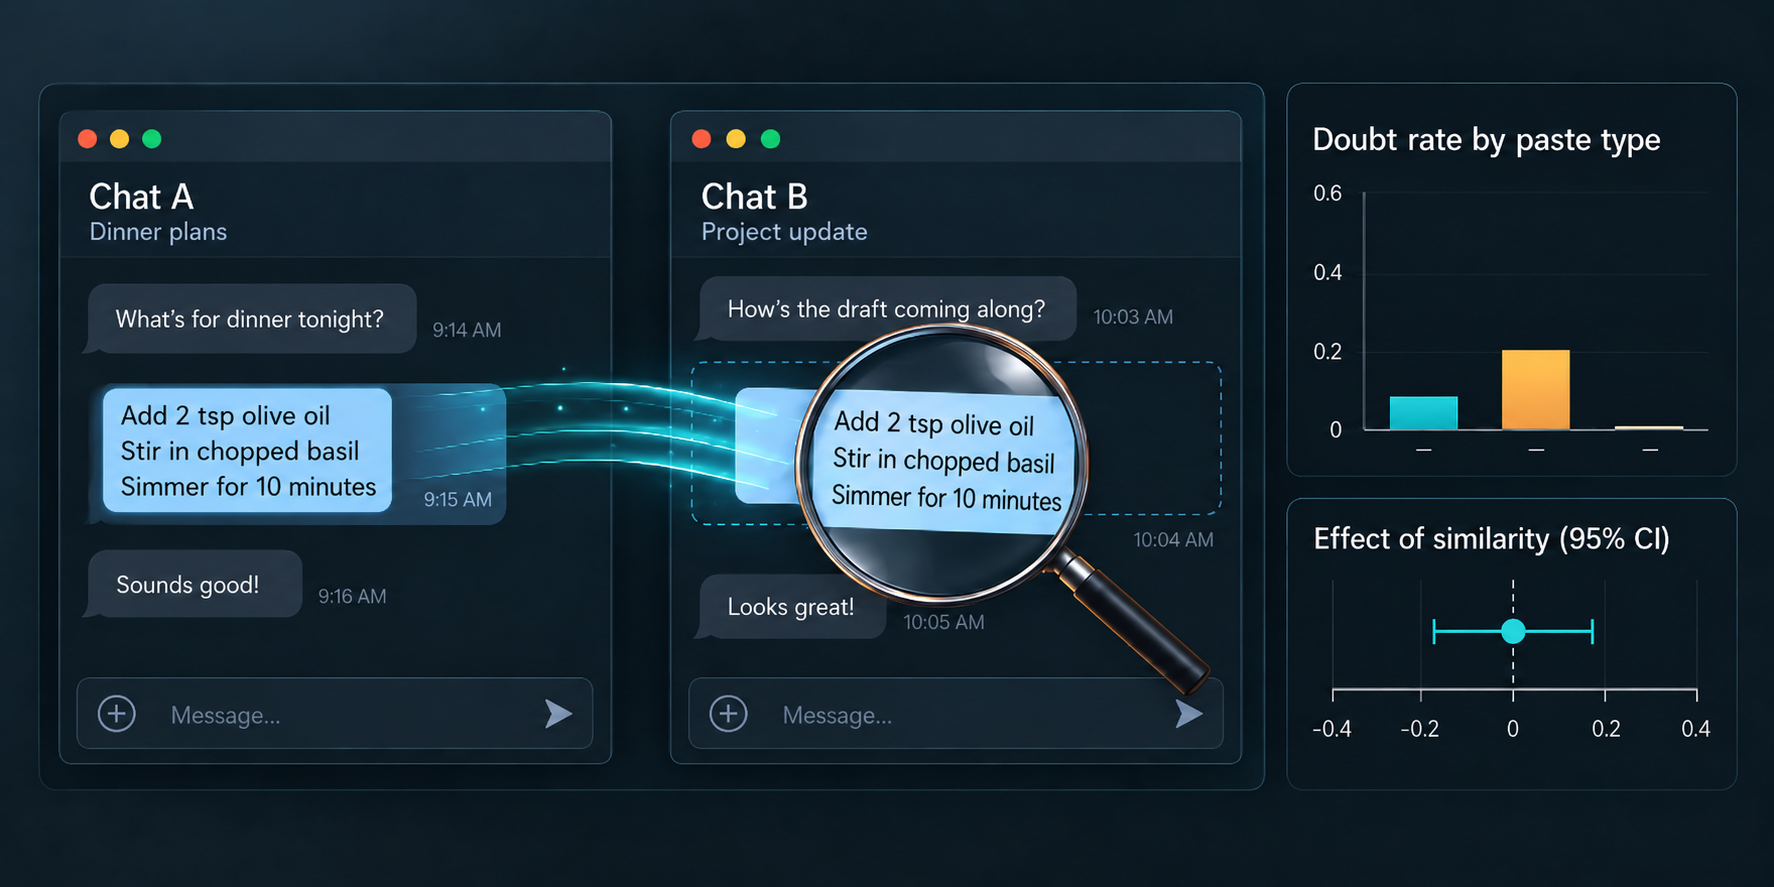
La señal funciona: de 6,6 % a 20,4 %, y la diferencia aguanta (p = 0,006).
Con el pegote adecuado, uno de cada cinco se plantea que te hayas equivocado.
Pero N2, el techo, dio cero de noventa y cinco. Menos que el banco neutro. Y mirando qué hacen en su lugar se entiende por qué: en N2 se dispara ejecuta en silencio, setenta y siete de noventa y cinco. El modelo acepta el dato nuevo, rehace el consejo y no registra el choque.
Tiene una lectura que me parece la mejor frase del experimento: una contradicción no se lee como un accidente, se lee como que has cambiado de opinión. Y acatar un cambio de opinión del usuario es exactamente lo que un asistente está entrenado para hacer.
Eso reordena la pregunta. Lo que hace dudar no es que el pegote sea incompatible con la conversación. Es que sea ajeno a ella: que lleve dentro las marcas de haber sido escrito para otro sitio.
Entonces, ¿el parecido importa?
Si lo que delata al pegote es venir de fuera, la hipótesis obvia es que cuanto más se parezca al tema en curso, menos se note. Es la pregunta que la tanda siguiente fue a medir, barriendo el eje de similaridad entero.
La respuesta corta es no.
Esa última frase es la parte que costó. La primera versión de esta tanda también salió plana, y estuve a punto de dar el eje por cerrado. No lo estaba: al calcular la potencia después —que es precisamente cuando descubres que había que calcularla antes— resultó que aquel diseño tenía un 11 % de probabilidad de detectar el efecto que yo mismo había declarado relevante. Un resultado plano con esa potencia no dice «no hay efecto». Dice «no lo habríamos visto».
Rehacer el diseño para que un nulo significara algo obligó a tres cambios, y ninguno era el que yo esperaba:
- Correr un solo modelo. La conducta solo existe en uno: en las tandas
anteriores
claude-opus-5da 55 % de duda en el brazo con señal,gpt-5.6-solun 9 %, ygpt-5.6-lunacero de noventa y seis. Gastar un tercio del presupuesto en un modelo que nunca duda no compra información: compra ceros. - Más estímulos distintos, no más conversaciones. Con ocho temas y dos longitudes hay dieciséis conversaciones de partida, y cada punto del eje veía las mismas dieciséis. Repetirlas no informa; hubo que escribir cuarenta artefactos más.
- Tirar los turnos posteriores. La categoría se decide en la primera respuesta al pegote, y los dos turnos siguientes costaban el 72 % de la factura. Se generarán aparte cuando hagan falta.
Con eso, 1.344 conversaciones y potencia del 88 %. Y la respuesta sigue siendo que no: el parecido no predice si el modelo va a dudar de ti.
El hallazgo que no iba en el guion
A esta escala ya no se pueden leer todas las conversaciones a mano, así que clasifican dos modelos jueces. Pero de cada tanda me siento a etiquetar un puñado yo, a ciegas, sin ver lo que han dicho ellos. Es la parte más aburrida del experimento y es la que ha dado los dos hallazgos que siguen.
El primero: el juez se equivocaba en una dirección concreta. En la primera tanda repartía la categoría de la duda con demasiada alegría —treinta veces donde yo contaba trece— y siempre en el mismo sentido, nunca al revés. Un error sistemático así no se ve en el porcentaje final: se ve al poner las etiquetas de uno al lado de las del otro.
El segundo apareció etiquetando la última tanda, y es más de fondo. Las categorías no son excluyentes. Una respuesta puede señalar el salto de tema y adoptar el rol que el pegote describe —lo hace, de hecho— y la rúbrica te obliga a elegir una de las dos verdades. Es un defecto del instrumento, no del modelo, y llevaba tres tandas dentro sin que nadie lo viera.
Medirlo dio algo más grande de lo que yo esperaba. Volviendo a juzgar ciento cincuenta conversaciones con una rúbrica de dos ejes —¿reconoce la discontinuidad? y ¿qué hace con el pegote?—, ciento veinticuatro ocupan una combinación que la rúbrica vieja no puede expresar.
Pero el fallo no estaba donde yo lo buscaba. «Señala el salto y además adopta el rol», el caso que me hizo sospechar, aparece una sola vez en ciento cincuenta. Lo que faltaba era una casilla entera que no había nombrado nadie.
La conducta que faltaba es negar una premisa del pegote: «no tengo constancia de esa conversación», «no soy Tomás», «en este hilo no hemos fijado ese formato». No es señalar que el tema ha cambiado. No es dudar de que quisieras mandarlo. Es una tercera cosa: el modelo no te corrige a ti, corrige el mundo que el pegote da por hecho.
Y es la reacción más frecuente de la tanda: cuarenta de cada cien. La taxonomía del artículo anterior no la vio porque salió de veinticuatro conversaciones, y en veinticuatro apenas asoma cuatro veces.
Lo que me llevo
Sobre los modelos. Lo que hace que se planteen tu error no es que el texto choque con la conversación, sino que lleve dentro señales de haberse escrito para otro sitio. Contradecirte no te delata: te obedece. Y hay una forma de reaccionar —negar lo que el pegote da por supuesto— que es la más común de todas y que ni siquiera estaba en el mapa.
Sobre medir con jueces automáticos. Delegar la clasificación en un modelo es lo único que hace viable una tanda de mil conversaciones, y también lo que te deja sin saber qué estás contando. Los dos errores que encontré —un juez que inflaba una categoría en una sola dirección, y una rúbrica que obliga a elegir entre dos cosas ciertas a la vez— no salen en ninguna métrica agregada. Salen de sentarse a etiquetar sesenta conversaciones a mano y comparar.
Y sobre no concluir de más. La primera tanda del eje salió plana y no significaba nada: tenía un 11 % de probabilidad de detectar el efecto que yo mismo había declarado relevante. Un resultado plano así no dice «no hay efecto», dice «no lo habríamos visto». Y una hipótesis que la tanda pequeña insinuaba —que las conversaciones largas producen más duda— se dio la vuelta al medirla con catorce veces más datos.
Ninguna de las dos cosas se ve mirando los datos. Se ven calculando antes cuánto tendrías que ver para creerte lo que vas a decir.
Queda la parte que da nombre a la serie: qué pasa después, cuando el usuario escribe «perdona, eso era de otro chat». Eso es la Fase 2, y es el artículo siguiente.
Código, datos y rúbricas: llm-wrong-paste. Las 1.920 conversaciones, los veredictos de los dos jueces y las etiquetas humanas están en el repositorio, con los fallos dentro.