Cuando el dato deja de ser cierto
En este artículo
Réplica de SKILL.state: Scalable Long-Horizon Agent Skills (Badhe, Tiwari y Chung, aceptado en EMNLP) con dos modelos y más de 500 episodios. Cada número de este artículo es un recuento de decisiones, no un promedio de episodios.
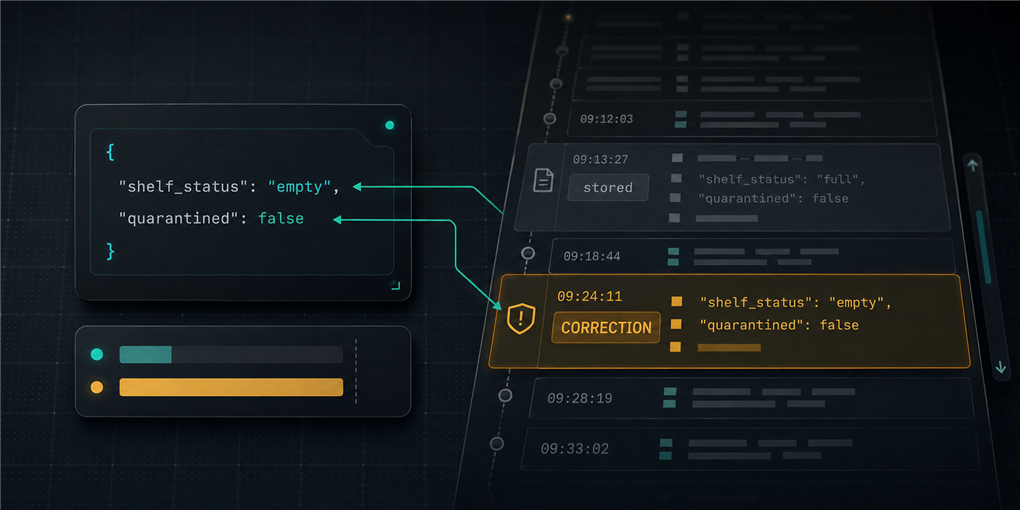
Un agente lee un evento en el paso 10: el palé que registraste en el paso 3 nunca llegó a colocarse; esa estantería está vacía. Veinte pasos después tiene que decidir dónde almacenar el siguiente palé. La respuesta correcta es la estantería que liberó la corrección.
Con el transcript entero en su contexto —el registro original, la corrección, y todo lo que hay en medio— Claude Haiku 4.5 acierta esa decisión 3 veces de 44. Dándole en su lugar un objeto JSON de 200 caracteres, y ningún transcript, el mismo modelo acierta 44 de 44.
Es el efecto más fuerte de toda la réplica, y también es lo que el paper afirma: su Experimento 3 dice que los runtimes con historia alucinan entre cinco y ocho turnos tras una corrección, y que el estado explícito recupera en cero. Lo nuevo de aquí abajo es la unidad de medida, no el signo.
Qué propone el paper
SKILL.state sustituye la historia de conversación append-only de un agente estilo ReAct por un estado de ejecución explícito y mutable. En cada paso el modelo recibe el procedimiento P, el estado actual Σ_t y la última observación O_t. Responde con un parche JSON y una acción. El parche se valida y se fusiona, Σ_{t+1} = Σ_t ⊕ ΔΣ_t, y el razonamiento que lo produjo se descarta. No se acumula nada.
La afirmación tiene dos mitades: más precisión en procedimientos largos, y un prompt que se mantiene O(1) en vez de crecer O(T).
SkillExecBench no tiene código público, así que el entorno de aquí es una reimplementación a partir de la descripción de su §4.1 —un almacén de 500 estanterías con registros densos de campos separados por barras—, igualada en densidad de contexto y no en contenido literal, y corriendo un 1,2–1,5x por encima de la suya en prompt medio.
Una diferencia es deliberada y conviene decirla ya: su Tabla 1 corre sobre Gemini-3-Flash, y el resto del paper sobre Gemma-4-31B-it y Qwen-3-8B-it. Esta réplica corre Claude Haiku 4.5 y Claude Sonnet 5. Cuando un resultado de aquí no coincide con el suyo, la primera explicación candidata es la familia de modelo, no el método — y decidir cuál de las dos es resulta ser casi todo el trabajo.
La mitad que sí se replica
La curva de coste se reproduce exactamente. Prompt medio a T=50, en la misma unidad que reporta el paper —caracteres—: SKILL.state 2.157, plano desde T=10 (2.136) hasta T=50, frente a sus 1.773. ReAct: 16.437 y creciendo linealmente, frente a sus 11.931. O(1) contra O(T), como anuncian, con un 1,2–1,4x de su densidad.
La mitad de la precisión no, y lo interesante es que no lo hace en ningún horizonte de los que ellos probaron. Su degradación es un efecto de escala —ReAct cae de 0,90 a T=10 hasta 0,74 a T=200—, así que la única forma honesta de comprobarlo es correr su rango entero.
| runtime | T=10 | T=25 | T=50 | T=100 | T=200 |
|---|---|---|---|---|---|
| ReAct | 1,00 | 1,00 | 1,00 | 1,00 | 0,99 ±0,02 |
| SKILL.state | 1,00 | 1,00 | 1,00 | 1,00 | 1,00 ±0,00 |
| Stateful | 1,00 | 1,00 | 1,00 | 0,99 ±0,02 | — |
| Memory | 1,00 | 0,96 | 0,75 | 0,72 | — |
A T=200 el brazo del transcript sostiene un prompt de 48.000 caracteres y 690 eventos accionables, y falla una decisión de unas 600. En Gemini-3-Flash ese mismo brazo falla una de cada cuatro. Remedir la celda de SKILL.state a T=50 con 3 seeds × 6 repeticiones da 18/18 exactos a 1,000, desviación cero, así que tampoco es una tirada afortunada.
La fila de Memory parecía al principio un artefacto y no un resultado: su runtime es el único que hace una segunda llamada por paso, y a T=100 perdió 23, 14 y 2 respuestas de 100 por el tope de salida en las tres seeds, puntuando 0,58, 0,67 y 0,91 en ese orden. Así que se remidió con el doble de presupuesto de salida:
| Memory | tope 600 | tope 1.200 | respuestas truncadas |
|---|---|---|---|
| T=50 | 0,75 | 0,79 | 3–10 de 50 |
| T=100 | 0,72 | 0,71 | 12–37 de 100 |
Doblar el presupuesto subió el truncamiento —23 respuestas cortadas pasaron a 34 en la misma seed— y dejó el score donde estaba. El modelo llena el presupuesto que le den, y el score bajo no es lo que costaban las respuestas cortadas. Memory se degrada de verdad, y se degrada más que en el paper.
El motivo por el que los otros tres aguantan merece nombrarse, porque gobierna todo lo que viene después: en esta tarea la información portante nunca está lejos. El hueco liberado que el agente tiene que reutilizar está a 1,9 posiciones del tope de la pila de media, siete como mucho. Alargar el horizonte añade pasos sin alejar la información de su uso. Si quieres medir si un runtime recuerda, T no es la palanca — y de eso va el resto de este artículo.
El recuento de tokens no es la factura
El paper compara tokens. Quien lo pone en producción compara dinero, y en cuanto la caché de prompt está activa son cantidades distintas. Un transcript append-only es el prefijo cacheable ideal: cada paso reenvía exactamente lo que envió antes, más un sufijo. Un bloque que muta invalida la caché desde el punto en que muta.
Hay un número que hay que medir antes de que nada de esto signifique algo: el prefijo mínimo cacheable. Por debajo de él no cachea nada. En Claude Haiku 4.5 son 4.096 tokens exactos — un bloque de sistema de 3.984 tokens, enviado dos veces, no lee nada de caché; uno de 4.116 lo lee entero. Así que la respuesta depende de lo largo que sea tu procedimiento, y conviene tener los dos casos.
Procedimiento corto — 1.491 tokens. Por debajo del umbral, así que el procedimiento no cachea en ningún brazo. Solo cachea ReAct, y solo porque su transcript acumulado empuja el prefijo por encima de 4.096 él solo. La ventaja de SKILL.state sobre ReAct cae de 7,54x en tokens brutos a 1,39x en dinero. Y los órdenes tampoco coinciden: por tokens es SKILL.state < Memory < ReAct < Stateful; por dinero, SKILL.state < ReAct < Memory < Stateful.
Procedimiento realista — 5.243 tokens. Una referencia de los 112 campos que los eventos llevan de verdad, seis reglas de excepción, cinco ejemplos resueltos. Un procedimiento operativo real tiene esta forma. Ahora la mitad estática de cada brazo cachea, y pasan dos cosas:
- SKILL.state se abarata un 41%: de 64 por cada mil episodios. El procedimiento se hizo tres veces y media más largo y la factura bajó, porque cruzó el umbral. Memory pasa de ahorrar 0% a 48%, y Stateful de 0% a 22%.
- La ventaja en dinero se ensancha a 2,51x mientras la de tokens brutos se estrecha a 3,43x. En las dos condiciones el recuento bruto es la cifra equivocada para citar: dice 7,54x o 3,43x donde la factura dice 1,39x o 2,51x.
La fila sobre la que hay que actuar es Stateful. Manda casi exactamente lo que manda ReAct. Pone un bloque de estado mutante delante del transcript en vez de detrás —que es donde lo coloca la plantilla de su Apéndice A.3— y le facturan 162 por cada mil episodios. Mismo contenido, misma tarea, mismo score de 1,00. Una diferencia de 5,2x, y aguanta en las dos condiciones.
En Sonnet 5, con la entrada a 3x, eso son 486. Por cada mil episodios, el orden del prompt es una partida de cuatro cifras.
Dónde gana de verdad el estado explícito
El Experimento 3 del paper prueba qué pasa cuando el mundo cambia por debajo del agente, y lo cuenta como un sí/no sobre cuatro escenarios hechos a mano: los runtimes con historia se recuperan tras cinco a ocho turnos, SKILL.state tras cero. Es el resultado suyo que sí reproduce aquí, y la sonda de abajo lo mide por decisión en vez de por escenario: el agente registra un palé en el paso t; en t+10 una corrección dice que aquella colocación nunca se completó y la estantería está vacía. Desde ahí esa estantería es la libre más baja, y todas las decisiones posteriores dependen de haber aplicado la corrección.
Dos decisiones de diseño hacen que esto sea medible. La primera: la unidad de recuento no es el episodio ni la seed, sino el paso dependiente —cada paso posterior al aviso cuya acción correcta cambia por él—. La segunda: las seeds se eligen por rango medido antes de gastar nada. Un agente perfecto pero sordo, que lo ejecuta todo bien y simplemente nunca aplica la corrección, define el suelo, y las seeds difieren enormemente en cuánto sitio dejan por encima:
| seed | suelo del perfecto-pero-sordo | pasos dependientes |
|---|---|---|
| 0 | 0,931 | 2 |
| 1 | 0,893 | 3 |
| 2 | 1,000 | 0 |
| 4 | 0,522 | 11 |
| 6 | 0,846 | 4 |
| 10 | 0,759 | 7 |
Las seeds 4, 10 y 6 aportan 22 pasos dependientes por repetición. Las seeds 0, 1 y 2 aportan cinco entre las tres, y una de ellas no aporta ninguno. Calcular esa tabla cuesta cero llamadas a la API.
Tres cosas que solo se ven contando decisiones en vez de promediando episodios:
El brazo del transcript falla todo o nada por escenario. En Haiku, los errores de cualquier otro tipo son exactamente cero en los seis episodios: sus únicos fallos son los pasos de la corrección, y los falla en bloque — 11 de 11, 7 de 7, 4 de 4. No es un agente que se despiste. Es un agente que ejecuta un procedimiento de 50 pasos sin una falta mientras nunca actualiza un dato. En Sonnet aparece el mismo patrón de forma bimodal: un episodio aplica los 11 y la repetición siguiente sobre el mismo escenario falla los 11.
Más capacidad ayuda y no lo resuelve. Sonnet con el transcript completo pasa de 6,8% a 39,5%. Reconcilia la contradicción mucho más a menudo, y sigue perdiendo tres decisiones de cada cinco.
El estado explícito lo compra, y en Sonnet lo cobra en otro sitio. Sonnet emitió 66 parches fuera de esquema en 8 episodios, agotando los reintentos en 10 pasos que acabaron sin ninguna acción, lo que le costó 21 errores de otros tipos. Haiku emitió cero. El acierto sobre la corrección es del 100% en ambos; la fiabilidad del runtime depende del modelo, y eso es una propiedad del método, no de la tarea.
El mecanismo no tiene ningún glamour. El estado explícito tiene exactamente un sitio donde vive el dato, y corregirlo es la operación que el runtime ya ejecuta en cada paso. El transcript no borra nada: sostiene a la vez la afirmación y su desmentido, y cada paso posterior tiene que resolver la contradicción otra vez desde cero.
Tener un único sitio donde vive la verdad es una ventaja justo cuando la verdad cambia. Es lo que afirma el paper, no un contraejemplo. Lo que esto añade es un número debajo — todas las decisiones dependientes en vez de cuatro escenarios — y una réplica en dos modelos que él no probó.
Dónde el estado explícito no hace nada
La sonda complementaria: en el paso t el entorno anuncia que una estantería queda en cuarentena. En t + k esa estantería es la libre más baja y la acción correcta es saltársela. El paso dependiente y la estantería son idénticos para todo k; lo único que se mueve es la distancia entre la información y su uso. Aquí no se desmiente nada: el dato solo tiene que sobrevivir.
Y aquí el estado explícito, por sí solo, no hace absolutamente nada. Con k=40, Haiku con un objeto de estado y sin campo para el aviso: 0 de 24. Lo que cambia el resultado no es el runtime, sino dónde se le permite vivir al dato:
Tres intervenciones, medidas pareadas sobre las mismas seeds:
- Un campo de esquema que nombra el dato (
quarantined_shelves) lleva a Haiku de 0/24 al 100% y a Sonnet del 12% al 75%. Funciona porque quien diseñó el esquema anticipó exactamente ese dato, que es uno de los tres casos que el paper declara en Limitaciones y no mide (una actualización de estado que depende de una observación cuya relevancia no se reconoció al leerla), ahora con un número al lado. - Un campo genérico de texto libre (
notes, sin decir qué poner en él) saca 5/24 = 21% en Sonnet, intervalo 9–40%, estadísticamente indistinguible de no tener campo. En una seed saca 0/8, peor que nada. - Reinyectar el dato vigente en cada observación lleva a Haiku de 0/24 a 24/24 y a Sonnet del 12% al 83%, y no exige anticipar nada.
Y lo último se parte todavía más. El aviso reinyectado lleva tres de los quince campos del aviso original, subidos al principio. Repetir el aviso original entero verbatim en su lugar, en la misma posición y con la misma cabecera, 981 caracteres en vez de 67, saca 16/24 = 67%. Los tres intervalos de Wilson son disjuntos, y la versión destilada gana en las tres seeds.
O sea: poner el dato disponible recupera dos tercios del fallo. El tercio que queda es destilación — con el mismo dato presente en cada paso, enterrado entre catorce campos de metadatos operativos, el agente lo pasa por alto una de cada tres veces.
La versión práctica, acotada a lo que se midió (un entorno, k=40, la comparación de tres niveles solo en Haiku): si un dato sigue vigente muchos pasos, reinyecta el campo, no el registro. Un sistema que vuelca el documento entero al contexto se deja un tercio de los fallos sobre la mesa. Es la misma forma que el hallazgo de El andamiaje que pagas: la intervención que sobrevive es la que cambia qué está mirando el modelo, no la que le añade estructura alrededor.
Cuatro comprobaciones que este tipo de experimento necesita
Un experimento sobre agentes produce números esté midiendo algo o no, y cuando sale mal el resultado no es ruido: es un resultado limpio. Dos hallazgos de aquí estaban escritos del todo, con tablas e intervalos que no se solapaban, hasta que estas cuatro los retiraron.
- Calcula el suelo antes que el efecto. Simula un agente perfecto salvo que ignora exactamente lo que quieres medir. En las seeds 0, 1 y 2 ese agente saca 0,931, 0,893 y 1,000, así que el efecto máximo posible ahí promedia 0,06 y una seed no aporta información ninguna. Una separación de +0,199 medida en esas seeds era aritméticamente imposible antes de preguntarse qué la causaba.
- Cuenta los pasos sin acción aparte de los pasos con acción incorrecta. Ese +0,199 era truncamiento: el brazo del transcript perdía de 8 a 19 respuestas de 50 por el tope de salida, y una respuesta cortada antes de su línea
Action:puntúa como error. Subir el tope no lo arregla — 600 tokens dieron 19 truncadas, 1.500 dieron 11 y 4.000 dieron 18. Un presupuesto de salida fijo penaliza al brazo cuyo prompt crece, y el paper reporta que ReAct se degrada al crecerTsin reportar truncamiento. - Descompón el score por el tipo de paso que promedia. Un segundo entorno reportó una interacción con cambio de signo entre modelos, con intervalos disjuntos en las dos separaciones. Instrumentado, los cuatro brazos acertaban su regla portante; solo 5 de 34 pasos accionables la probaban, una política ciega sacaba 0,853, y el efecto reportado vivía entero en los pasos rutinarios. La sección se retiró.
- Conoce tu suelo de ruido. La misma seed, prompt idéntico byte a byte, ocho repeticiones: una seed alternó acierto y fallo ocho veces seguidas. El acierto de un solo paso arrastra decenas de puntos de ruido de muestreo; un promedio sobre ~170 eventos casi ninguno; la contabilidad de tokens ninguno.
Lo que me llevo
- El eje que se anuncia no es el eje. Cuánto contexto conservas apenas mueve la precisión en una tarea donde la información está cerca. Lo que la mueve es si el dato portante está presente, vigente y destilado en el momento de la decisión.
- El estado explícito se gana su sitio cuando los datos se invalidan. Un solo lugar que corregir le gana a un transcript que sostiene una afirmación y su desmentido — 93/93 contra 18/82, en los dos modelos. Si el mundo de tu agente solo acumula, esto te compra mucho menos.
- Comprimir contexto y cachear contexto están en conflicto. Todo método que reescribe su prefijo lo paga a precio completo. Mide la factura, no el recuento de tokens, y pon tu bloque mutante después de lo que quieras cachear.
- Un esquema solo protege contra lo que su diseñador anticipó. Un campo genérico para «ir apuntando cosas» midió indistinguible de no tener campo.
Todo esto está acotado a dos modelos, un entorno que discrimina y un procedimiento lo bastante corto como para quedar por debajo del umbral de caché. Lo que generaliza no es ningún número concreto sino la aritmética: comprueba que tu efecto cabe dentro del rango que tu efecto puede tener.
Réplica de SKILL.state: Scalable Long-Horizon Agent Skills (Badhe, Tiwari y Chung, aceptado en EMNLP). Relacionados: El andamiaje que pagas, sobre intervenciones que cuestan más de lo que compran, y El olvido que no mides, sobre lo que esconde un número de benchmark.
Corrección, 13 de septiembre de 2026: una versión anterior de este artículo presentó el resultado de invalidación retroactiva como una contradicción de una limitación declarada en el paper. No lo es. El paper reserva ese caso para tareas cuyo objetivo es la propia historia — auditar, explicar acciones pasadas —, que esta sonda no prueba, y su Experimento 3 ya informa de la misma dirección de forma cualitativa. La aportación es la métrica, no el signo.